Predicción de deserción estudiantil con Machine Learning: alerta temprana sin fuga de datos
Sigue leyendo si vas a construir un modelo de predicción de deserción « tesis, trabajo o portafolio » y no te basta con copiar código: quieres entender por qué se tomó cada decisión, como usar o no las variables del 2do semestre o elegir entre Accuracy y Recall, para poder desarrollar tu propio proyecto.
Parte 1 de 3
Contexto del proyecto
Al terminar, sabrás hacer esto
No son conceptos abstractos. Son decisiones que podrás tomar y justificar en una tesis, en una entrevista o en un proyecto real.
- Pipeline de punta a punta: construyes un flujo completo de clasificación, del dataset al modelo explicado, con datos académicos y socioeconómicos reales de 3,630 estudiantes de educación superior.
- Alerta temprana honesta: decides con evidencia qué variables existen a tiempo para alertar, y mides cuánto AUC cuesta predecir antes en lugar de describir una deserción que ya ocurrió.
- Evaluación sin fugas: haces que el escalado, el balanceo de clases y el umbral se ajusten solo con datos de entrenamiento o validación, y usas el conjunto de prueba una sola vez.
- Métrica correcta con clases desbalanceadas: entiendes por qué un modelo que nunca detecta a nadie logra 0.608 de Accuracy, y eliges con Recall, F1 y AUC.
- Comparación de modelos: pones a competir regresión logística, Random Forest, Gradient Boosting, XGBoost y SVM con las mismas particiones, y afinas el mejor con GridSearchCV.
- Umbral de alerta: eliges el punto de corte con la curva precisión-recall y lo traduces a lo que le importa a una institución: a cuántos estudiantes en riesgo detectas y a cuántos contactas sin necesidad.
- Interpretabilidad con SHAP: explicas qué variables empujan cada predicción hacia la deserción o hacia la graduación, a nivel global y de un estudiante individual.
- Criterio para adaptarlo: identificas en qué punto del pipeline tocar el código si cambian tus datos, tu corte temporal o tu métrica, y cómo saber si el cambio mejoró algo.
Modos de uso
- Tesis: replicación crítica de un modelo de deserción, con corte temporal justificado y evaluación sin fuga de datos.
- Trabajo: pipeline replicable con los datos de cualquier institución que registre desenlaces y calificaciones por semestre.
- Portafolio: demuestra que sabes elegir una métrica, evitar fugas y explicar un modelo, no solo entrenarlo.
Prerrequisitos
- Python intermedio: funciones, listas y diccionarios, y haber usado pandas o numpy alguna vez. No necesitas ser experto.
- Nociones de estadística básica: qué es una proporción, una media y una correlación. Se usan en todas las etapas.
- Cero experiencia previa en SMOTE, SHAP o sistemas de alerta temprana. Eso es justo lo que cubre la sección de fundamentos.
Brief del proyecto
Cada semestre, una institución de educación superior pierde estudiantes que ya estaban inscritos, ya cursaban materias y, en muchos casos, ya habían dado señales de que algo no iba bien.
Esas señales suelen estar en los datos: cuántas unidades aprobó en el primer semestre, con qué calificación, si su matrícula está al corriente, si tiene beca, con qué edad entró.
El problema es de tiempo. Saber que un estudiante desertó es fácil, porque ya se fue. Lo útil es saberlo antes, cuando todavía se le puede ofrecer tutoría, apoyo económico o simplemente una conversación.
En el dataset de este proyecto, de cada 100 estudiantes que terminaron su proceso, unos 39 desertaron y 61 se graduaron. Un modelo que apuesta siempre por la graduación acertaría 61 veces de cada 100 y no detectaría a ninguno de los que se van.
Qué está en juego: cada estudiante que se va es una trayectoria interrumpida y un costo para la institución. Una alerta que llega tarde no sirve, y una que llega a tiempo pero se equivoca mucho desgasta al equipo que tiene que atenderla.
Este es un proyecto demostrativo con datos públicos de una sola institución. No es una herramienta para decidir sobre personas: es un ejemplo de cómo construir y evaluar un modelo de este tipo con criterio.
Para construir una buena alerta necesitas responder estas dos preguntas:
- ¿Qué información existe a tiempo para alertar?
- ¿Cómo entrenar y medir el modelo sin engañarte?
La primera parece un problema técnico y es de criterio: las variables que mejor predicen la deserción son justo las que se registran cuando ya ocurrió. Este proyecto mide cuánto cuesta renunciar a ellas.
La segunda necesita disciplina: con clases desbalanceadas, un Accuracy alto puede esconder un modelo inútil, y una validación mal armada puede regalarte un resultado que no existe. Cada etapa del proyecto cierra una de esas puertas.
Diagrama de la solución
El pipeline responde dos preguntas en orden, y la respuesta de la primera decide con qué información puede trabajar la segunda Figura 1.
Datos y fricción real
Antes de tocar el pipeline, esto es lo que realmente te vas a encontrar en los datos de este proyecto: no una advertencia genérica sobre «datos sucios», sino la fricción concreta que después justifica decisiones puntuales más adelante.
- Son tres clases, no dos. El dataset trae 4,424 estudiantes con tres desenlaces: Dropout, Enrolled y Graduate. Los Enrolled siguen inscritos y todavía no tienen desenlace, así que se excluyen y quedan 3,630 estudiantes.
- Las mejores variables llegan tarde. Las columnas más correlacionadas con la deserción son las del 2do semestre, y tienen una explicación simple: quien deserta a mitad del semestre casi no aprueba unidades en ese periodo. Usarlas no es fuga entre entrenamiento y prueba, pero el modelo terminaría detectando algo que ya pasó. La decisión «¿Predecir con todas las variables o solo con las que existen antes del 2do semestre?» del Desarrollo lo resuelve con evidencia.
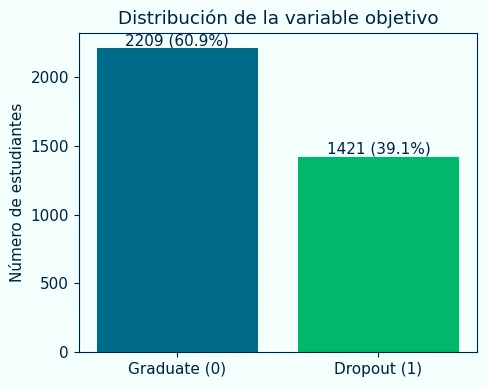
- El desbalance es moderado, no extremo. Dropout es el 39.1% y Graduate el 60.9%. Es suficiente para que el Accuracy engañe y para que la elección de la estrategia de balanceo importe.
- Las categóricas llegan como enteros. Estado civil, modo de aplicación o curso vienen codificados con números que no tienen orden real. El proyecto los deja como llegan; si tu caso lo necesita, codificarlas es un cambio de features, no de arquitectura.
- El tipo de dato puede romper SHAP más adelante. Algunas columnas llegan de la descarga con dtype
category, y XGBoost activa entonces su soporte categórico, que SHAP no acepta. Por eso las variables se convierten afloatdesde el inicio. - La descarga depende de un servicio externo. El notebook intenta primero
ucimlrepoy, si falla, cae al archivo publicado por la UCI. Si ambas fallan, revisa tu conexión antes de asumir que el código tiene un error. - Una sola institución y una sola cohorte. Los resultados describen a esta institución. Si tu contexto es otro, es una hipótesis que tienes que validar con tus datos.
- Lo que este dataset no resuelve. No incluye asistencia, actividad en plataforma ni contacto con tutores, que existen antes que cualquier calificación. Si tu caso necesita esas fuentes, es un cambio de features, no de arquitectura.
Fundamentos teóricos de la solución
Estas cuatro ideas son la base conceptual de todo lo que sigue. Si ya conoces alguno de estos temas, puedes saltarlo.
No hay código aquí a propósito. La idea es que entiendas qué resuelve cada pieza antes de ver cómo se implementa.
En resumen:
- Fuga de datos responde «¿mi resultado es honesto?».
- SMOTE responde «¿cómo le enseño al modelo a ver a la minoría?».
- Recall, precisión y umbral responden «¿a cuántos en riesgo detecto y a cuántos molesto sin necesidad?».
- SHAP responde «¿por qué el modelo alerta a este estudiante?».
Con estas cuatro ideas ya tienes el mapa mental completo: lo que sigue es ver cómo se traduce en código.
¿Qué es la fuga de datos y por qué infla un modelo?
La fuga de datos ocurre cuando el modelo, o cualquier paso previo, usa durante el entrenamiento información que no tendría al momento de predecir. El resultado es una métrica que se ve muy bien y no se sostiene fuera del notebook.
Hay dos formas frecuentes. La primera es mezclar información de prueba con la de entrenamiento, por ejemplo, calculando la media para escalar sobre todos los datos. La segunda es temporal: usar variables que solo existen después del momento en que querías predecir.
Este proyecto cuida las dos. Todo lo que aprende de los datos vive dentro de un Pipeline que se ajusta solo con el fold de entrenamiento, y las variables del 2do semestre se descartan porque llegan cuando la deserción ya ocurrió.
¿Qué es SMOTE y cuándo conviene usarlo?
Cuando una clase es minoritaria, el modelo tiene pocos ejemplos de ella y tiende a apostar por la mayoritaria. SMOTE «Synthetic Minority Over-sampling Technique» genera ejemplos sintéticos de la clase minoritaria interpolando entre estudiantes reales parecidos.
La alternativa más simple es el peso de clase: no crea datos, solo penaliza más los errores sobre la minoría. Ninguna de las dos es siempre mejor, y por eso este proyecto las compara con la misma validación cruzada.
El riesgo de SMOTE es dónde se aplica. Si se aplica antes de dividir en folds, algunos ejemplos sintéticos comparten información con ejemplos reales del fold de validación y las métricas quedan infladas. Debe vivir dentro del Pipeline, activo solo en el entrenamiento de cada iteración.
¿Qué significan Recall, precisión y umbral en una alerta?
El Recall responde: de todos los estudiantes que desertaron, ¿a cuántos alertó el modelo? La precisión responde: de todos a los que alertó, ¿cuántos desertaron de verdad? Una sube casi siempre a costa de la otra.
El umbral es la probabilidad a partir de la cual el modelo lanza la alerta. Con 0.5 alerta cuando cree que es más probable la deserción que la graduación, pero ese número no tiene nada de especial para tu problema.
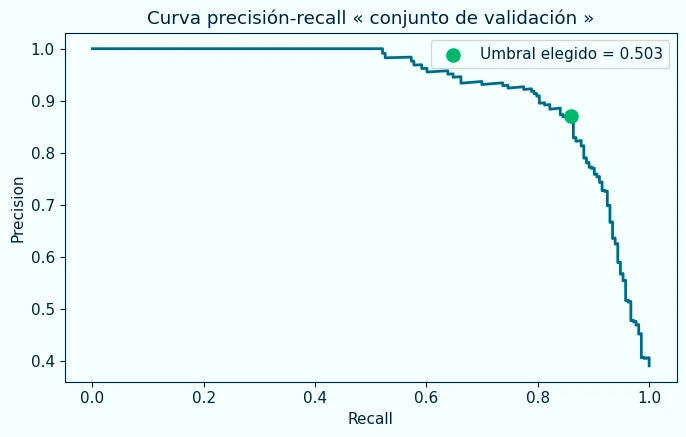
La curva precisión-recall muestra qué pasa con las dos métricas al mover el umbral. Elegir un punto de esa curva es elegir a cuántos estudiantes vas a contactar y cuántos de ellos realmente lo necesitaban.
¿Qué es SHAP y por qué importa en un modelo de alerta?
Un Random Forest predice bien y explica poco. SHAP reparte cada predicción entre las variables: para cada estudiante dice cuánto empujó cada una hacia la deserción o hacia la graduación.
A nivel global, promedia esos empujes y muestra qué variables pesan más en el modelo. A nivel individual, explica por qué una alerta en particular se lanzó.
Eso importa porque una alerta sin razón no le sirve a quien tiene que actuar: saber que el estudiante aprobó pocas unidades o tiene la matrícula vencida define qué apoyo ofrecerle.
Explorador de decisiones
Antes de leer cómo se construyó el pipeline, prueba tú mismo dos de sus decisiones. Es una muestra rápida: las 5 decisiones del proyecto se exploran igual, justo donde aparecen en el desarrollo.
Parte 2 de 3
Desarrollo del proyecto
¿Qué construyes?
Este proyecto integra tres piezas de un sistema de alerta temprana en un solo pipeline: una definición honesta de qué información existe a tiempo, un entrenamiento y una selección de modelo sin fuga de datos y una explicación de cada alerta. Lo que lo distingue es cómo se evalúa: cada decisión se pone a prueba contra su alternativa, con los mismos datos y la misma validación.
El punto de partida es el dataset público «Predict Students' Dropout and Academic Success» de la UCI «Realinho et al., 2021», con 4,424 estudiantes de una institución portuguesa de educación superior. Después de excluir a los que siguen inscritos quedan 3,630, con 36 variables académicas, demográficas y socioeconómicas y sin valores nulos.
El modelo predice un solo desenlace: si el estudiante termina en Dropout o en Graduate. El resultado final se mide una sola vez, en un conjunto de prueba que ninguna decisión anterior tocó.
Decisión clave
¿Esto es un problema de clasificación binaria o multiclase?
Binaria: Dropout contra Graduate, con un solo umbral de alerta que se puede traducir a una decisión.
Multiclase: conserva también Enrolled, pero esos estudiantes todavía no tienen desenlace y la etiqueta no dice qué pasó.
Se eligió: clasificación binaria. Enrolled significa que el estudiante sigue inscrito, así que no hay resultado que aprender, y se excluye.
¿Y si tu caso es distinto? Si tu institución ya conoce el desenlace de todos sus estudiantes, incluidos los que siguen inscritos pasado el plazo, puedes conservar la tercera clase. Las métricas por clase y el manejo del desbalance se vuelven más complejos: empieza en binario.
Insight de experto: La pregunta más importante de todo el pipeline no es qué modelo usar, sino qué sabías y cuándo lo sabías. Un modelo con un AUC de 0.946 que usa datos de mitad del 2do semestre alerta tarde. Uno con 0.930 que usa solo lo que existe antes de ese semestre puede cambiar el rumbo de un estudiante. Por eso la pregunta que recorre todo el proyecto es cuánto cuesta alertar a tiempo.
Arquitectura del pipeline
- Datos: dataset de la UCI con las clases Dropout y Graduate, descargado con
ucimlrepo. - Split estratificado: 70% entrenamiento, 15% validación y 15% prueba, con la misma proporción de deserción en las tres.
- Corte temporal: solo las 30 variables de admisión y 1er semestre; las 6 del 2do semestre se descartan.
- Pipeline sin fuga: escalado, SMOTE y modelo dentro de cada fold de validación cruzada.
- Benchmarking y afinación: cinco modelos con validación cruzada y GridSearchCV sobre el mejor.
- Umbral de alerta: punto de corte elegido con la curva precisión-recall de validación.
- Evaluación final y SHAP: una sola vez en test, más la explicación de cada predicción.
El Diagrama de la solución Figura 1 muestra estas mismas piezas agrupadas por la pregunta que responde cada una.
Stack tecnológico
- Python «lenguaje principal»
- pandas / numpy «manipulación de datos»
- ucimlrepo «descarga del dataset desde el repositorio de la UCI»
- scikit-learn «Pipeline, StandardScaler, regresión logística, Random Forest, Gradient Boosting, SVM, GridSearchCV y métricas»
- imbalanced-learn «SMOTE y el Pipeline que lo aplica solo al entrenamiento»
- XGBoost «modelo de boosting del benchmarking»
- SHAP «explicación global e individual de las predicciones»
- matplotlib «todas las figuras de resultados»
Probado de principio a fin el 25 de septiembre de 2026 con pandas 2.2.3, numpy 2.1.3, scikit-learn 1.6.1, xgboost 3.4.1, shap 0.52.0 e imbalanced-learn 0.14.2.
Etapa 1 de 8
Datos y reproducibilidad
Fija todo el experimento en una sola celda, descarga el dataset y déjalo listo para clasificar. Desde aquí, cada número del proyecto sale de la misma semilla.
El proyecto corre en Google Colab o localmente. No necesita GPU: son modelos de scikit-learn y XGBoost sobre 3,630 filas.
Configuración del experimento
La semilla y el esquema de validación cruzada se definen una vez y las reutiliza todo el notebook. Se imprimen las versiones de cada librería, porque un resultado sin su entorno no se puede reproducir.
!pip install -q ucimlrepo shap imbalanced-learn xgboost --upgrade

import warnings
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)

import pandas as pd
import numpy as np
import sklearn
import xgboost
import shap
import imblearn
from sklearn.model_selection import StratifiedKFold

SEED = 42
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEED)

print(f"pandas            {pd.__version__}")
print(f"numpy             {np.__version__}")
print(f"scikit-learn      {sklearn.__version__}")
print(f"xgboost           {xgboost.__version__}")
print(f"shap              {shap.__version__}")
print(f"imbalanced-learn {imblearn.__version__}")pandas 2.2.3 numpy 2.1.3 scikit-learn 1.6.1 xgboost 3.4.1 shap 0.52.0 imbalanced-learn 0.14.2
Error común
Correr sin fijar la semilla ni las versiones. Sin SEED, el split, la validación cruzada y la afinación cambian en cada corrida, y no puedes saber si una mejora es real o suerte. Aquí la misma semilla alimenta el split, el StratifiedKFold y cada modelo; compara tus versiones con las que imprime esta celda.
Carga del dataset de la UCI
El dataset se descarga en vivo con ucimlrepo. Si el paquete o la conexión fallan, la función cae al archivo que la UCI publica directamente, para que el notebook no dependa de un solo camino.
def cargar_dataset_uci():
    """Descarga el dataset real de UCI. Primero intenta ucimlrepo (más robusto,
    ya viene separado en features/target). Si falla, usa el CSV publicado
    directamente como respaldo."""
    try:
        from ucimlrepo import fetch_ucirepo
        ds = fetch_ucirepo(id=697)
        df = ds.data.features.copy()
        df["Target"] = ds.data.targets.values.ravel()
        print("Dataset cargado con ucimlrepo.")
        return df
    except Exception as e:
        print(f"ucimlrepo no disponible ({e}). Usando el CSV de respaldo de UCI.")
        url = ("https://archive.ics.uci.edu/static/public/697/"
               "predict+students+dropout+and+academic+success.zip")
        import io, zipfile, urllib.request
        with urllib.request.urlopen(url) as resp:
            contenido = resp.read()
        with zipfile.ZipFile(io.BytesIO(contenido)) as z:
            nombre_csv = [n for n in z.namelist() if n.endswith(".csv")][0]
            with z.open(nombre_csv) as f:
                df = pd.read_csv(f, sep=";")
        print("Dataset cargado desde el CSV de respaldo.")
        return df

df_crudo = cargar_dataset_uci()
print(df_crudo.shape)
df_crudo.head()Dataset cargado con ucimlrepo. (4424, 37)
Qué significa cada dato
- Variables numéricas. Rendimiento académico por semestre «unidades aprobadas y calificaciones», edad al inscribirse e indicadores macroeconómicos del año de inscripción.
- Variables categóricas codificadas como enteros. Estado civil, modo de aplicación, curso, nacionalidad y calificación de los padres, entre otras.
- Variables binarias. Si el estudiante es deudor, si tiene la matrícula al corriente, si tiene beca, si es desplazado y si tiene necesidades educativas especiales.
- La clase objetivo. Dropout, Enrolled o Graduate. Aquí se filtra a Dropout contra Graduate y se crea la columna
desercion, con 1 para Dropout y 0 para Graduate.
df = df_crudo[df_crudo["Target"].isin(["Dropout", "Graduate"])].copy()
df["desercion"] = (df["Target"] == "Dropout").astype(int)
df.drop(columns=["Target"], inplace=True)

print(f"Filas tras filtrar Enrolled: {df.shape[0]}")
print(f"Columnas: {df.shape[1] - 1} features + 1 target")
print()
print("Valores nulos por columna (debe ser 0 en todas):")
print(df.isnull().sum().sum(), "nulos en total")
print()
print("Distribución de la clase objetivo:")
print(df["desercion"].value_counts(normalize=True).rename({0: "Graduate", 1: "Dropout"}))Filas tras filtrar Enrolled: 3630 Columnas: 36 features + 1 target Valores nulos por columna (debe ser 0 en todas): 0 nulos en total Distribución de la clase objetivo: desercion Graduate 0.60854 Dropout 0.39146 Name: proportion, dtype: float64
Punto de adaptación: Este es el primer lugar donde tocarías el código si tu proyecto usa otros datos: reemplaza df_crudo por tu tabla y la columna Target por tu desenlace. El resto del pipeline se ajusta solo.
Checkpoint «Datos»
- El dataset original tiene 4,424 filas y, tras filtrar Enrolled, quedan 3,630 con 36 variables y una columna objetivo
- La celda de configuración imprime las versiones de pandas, numpy, scikit-learn, xgboost, shap e imbalanced-learn
- No hay valores nulos y la deserción es el 39.1% de los estudiantes
Etapa 2 de 8
Análisis exploratorio
Dos gráficas, cada una responde una pregunta que después condiciona una decisión del pipeline.
¿Qué tan desbalanceadas están las clases?
Antes de decidir cómo manejar el desbalance hay que medirlo Figura 2. Dropout es minoritaria, pero no marginal.
¿Qué variables se parecen a la deserción?
La correlación se calcula sobre todas las variables disponibles, incluidas las del 2do semestre Figura 3. Ahí aparece algo que condiciona todo lo que sigue.
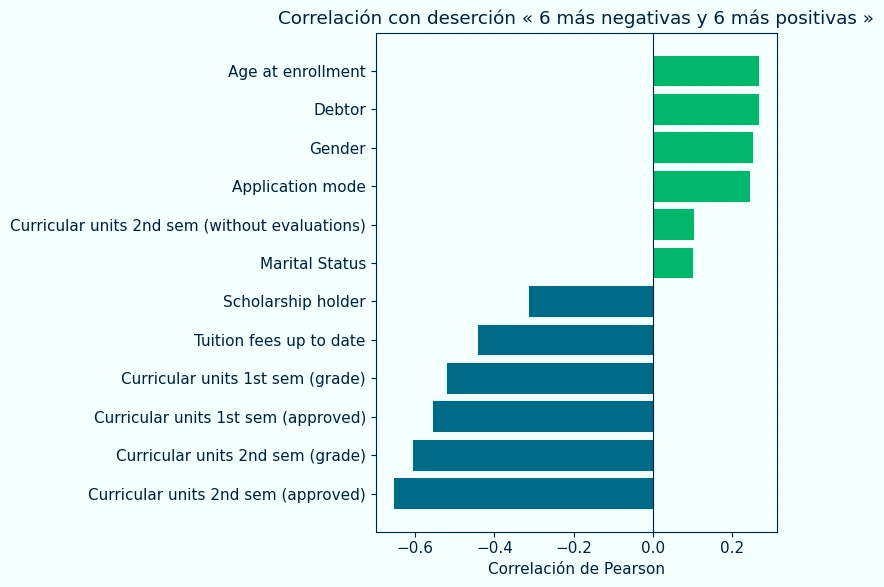
Las dos variables más correlacionadas son del 2do semestre. Tiene sentido: un estudiante que deserta a mitad del semestre casi no aprueba unidades ese semestre, porque esas unidades se registran al final del periodo, cuando la deserción ya ocurrió.
Lo que dice la Figura 3 marca la Etapa 3: la mejor señal disponible es también la que menos sirve para alertar a tiempo.
El código de las dos gráficas está en el notebook; aquí se muestran solo sus resultados.
Checkpoint «Exploración»
- Sabes que Dropout es el 39.1% de los estudiantes y por qué el Accuracy no bastará como métrica
- Identificas que las variables más correlacionadas con la deserción son las del 2do semestre
- Tienes claro que esa correlación es una razón para desconfiar, no para celebrar
Etapa 3 de 8
Split y corte temporal
Separa los datos en tres partes y decide con qué información se va a predecir. Las dos decisiones ocurren antes de entrenar un solo modelo.
Split estratificado
El split es estratificado por la clase en las tres particiones: 70% para entrenamiento, 15% para validación y 15% para prueba. Así cada una conserva la misma proporción de deserción.
- Entrenamiento. Donde se ajusta todo: escalado, SMOTE, modelos e hiperparámetros.
- Validación. Se usa más adelante, solo para elegir el umbral de alerta.
- Prueba. No se toca hasta la evaluación final, y se toca una sola vez.
Las variables se convierten a float desde aquí. No pierde información, porque ya son numéricas, y evita que XGBoost active su soporte categórico y rompa SHAP más adelante.
from sklearn.model_selection import train_test_split

# .astype(float) es deliberado: algunas columnas llegan de ucimlrepo con dtype
# "category". XGBoost detecta eso y activa soporte categórico automáticamente,
# lo que rompe SHAP más adelante ("Categorical split is not yet supported").
# Todas las columnas de este dataset ya son numéricas codificadas, así que
# convertir a float no pierde información, solo evita el dtype ambiguo.
X = df.drop(columns=["desercion"]).astype(float)
y = df["desercion"]

X_train, X_temp, y_train, y_temp = train_test_split(
    X, y, test_size=0.30, stratify=y, random_state=SEED
)
X_val, X_test, y_val, y_test = train_test_split(
    X_temp, y_temp, test_size=0.50, stratify=y_temp, random_state=SEED
)

for nombre, y_split in [("train", y_train), ("val", y_val), ("test", y_test)]:
print(f"{nombre:>5}: {len(y_split):4d} filas | % Dropout = {y_split.mean():.3f}")train: 2541 filas | % Dropout = 0.392 val: 544 filas | % Dropout = 0.392 test: 545 filas | % Dropout = 0.391
Corte temporal: ¿hasta cuándo es temprano?
Decisión clave
¿Con qué variables predecir: hasta la admisión y el 1er semestre, o también con el 2do semestre?
Todas las variables: el AUC más alto, porque incluye lo que casi describe el desenlace.
Solo las tempranas: un AUC menor, pero con información que existe cuando todavía se puede reaccionar.
Se eligió: solo admisión y 1er semestre. Es la única ventana donde una alerta temprana todavía sirve de algo, y la diferencia se mide en lugar de suponerse.
¿Y si tu caso es distinto? Si tu institución necesita alertar antes, por ejemplo a mitad del 1er semestre, tu corte es más estricto y el costo en AUC será mayor. Si solo quieres describir por qué desertaron los que ya se fueron, usar todas las variables es válido, pero entonces no le llames alerta temprana.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Predecir con todas las variables o solo con las que existen antes del 2do semestre?
Antes de ver el resultado, contesta esto:
Un estudiante que deserta a mitad del 2do semestre casi no aprueba unidades ese semestre. Si esa columna entra al modelo, ¿qué está prediciendo realmente: el riesgo o el desenlace?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →La celda compara el mismo modelo, una regresión logística con el escalado dentro del Pipeline, con todas las variables y solo con las tempranas, sobre la misma validación cruzada de 5 folds.
from sklearn.pipeline import Pipeline as SkPipeline
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import cross_validate

COLUMNAS_2DO_SEM  = [c for c in X_train.columns if "2nd sem" in c]
COLUMNAS_TEMPRANO = [c for c in X_train.columns if c not in COLUMNAS_2DO_SEM]

def auc_recall_con_columnas(columnas):
    pipe = SkPipeline([
        ("escalado", StandardScaler()),
        ("modelo", LogisticRegression(max_iter=1000, random_state=SEED)),
    ])
    scores = cross_validate(pipe, X_train[columnas], y_train, cv=cv,
                             scoring=["roc_auc", "recall"])
    return scores["test_roc_auc"].mean(), scores["test_recall"].mean()

auc_completo, recall_completo = auc_recall_con_columnas(X_train.columns.tolist())
auc_temprano, recall_temprano = auc_recall_con_columnas(COLUMNAS_TEMPRANO)

print(f"Con todas las variables (incluye 2do semestre):        AUC={auc_completo:.4f} | Recall={recall_completo:.4f}")
print(f"Solo con variables tempranas (admisión + 1er semestre): AUC={auc_temprano:.4f} | Recall={recall_temprano:.4f}")
print(f"Costo de predecir temprano: {auc_completo - auc_temprano:+.4f} de AUC")

CORTE_ELEGIDO = "temprano"
X_train = X_train[COLUMNAS_TEMPRANO].copy()
X_val   = X_val[COLUMNAS_TEMPRANO].copy()
X_test  = X_test[COLUMNAS_TEMPRANO].copy()
X       = X[COLUMNAS_TEMPRANO].copy()

print(f"\nSe continúa con el corte '{CORTE_ELEGIDO}'. "
f"Columnas descartadas: {len(COLUMNAS_2DO_SEM)}. Columnas usadas de aquí en adelante: {X_train.shape[1]}.")Con todas las variables (incluye 2do semestre): AUC=0.9463 | Recall=0.8302 Solo con variables tempranas (admisión + 1er semestre): AUC=0.9303 | Recall=0.7910 Costo de predecir temprano: +0.0159 de AUC Se continúa con el corte 'temprano'. Columnas descartadas: 6. Columnas usadas de aquí en adelante: 30.
Predecir temprano cuesta 0.0159 de AUC y baja el Recall de 0.8302 a 0.7910. A cambio, las 30 variables que quedan existen al terminar el 1er semestre y la alerta llega antes de que empiece el siguiente.
Desde esta celda, X_train, X_val, X_test y X tienen solo esas 30 columnas. Todo lo que sigue se construye sobre ellas.
Error común
Llamarle «alerta temprana» a un modelo que usa datos del 2do semestre. No es fuga entre entrenamiento y prueba, pero el modelo termina detectando una deserción que ya pasó. Un AUC alto con esas columnas se ve bien en el reporte y no sirve el día en que tenías que actuar.
Punto de adaptación: COLUMNAS_2DO_SEM se arma buscando el texto «2nd sem» en el nombre de cada columna. Con tus datos, define a mano la lista de variables que se registran después de tu punto de alerta.
Checkpoint «Corte»
- Los tres conjuntos tienen 2,541, 544 y 545 estudiantes, con 39.2%, 39.2% y 39.1% de deserción
- Predecir temprano cuesta 0.0159 de AUC, medido con el mismo modelo y la misma validación
- Quedan 30 columnas; las 6 del 2do semestre se descartaron de entrenamiento, validación y prueba
Etapa 4 de 8
Manejo del desbalance
Compara tres formas de enseñarle al modelo a ver a la clase minoritaria, y queda con la que detecta más estudiantes en riesgo sin hundir la precisión.
Decisión clave
¿Sin balanceo, con peso de clase o con sobremuestreo sintético «SMOTE»?
Sin balanceo: la más simple, pero el modelo aprende que apostar por la mayoría es lo seguro.
Peso de clase: penaliza más los errores sobre la minoría, sin tocar los datos.
SMOTE: genera ejemplos sintéticos de la minoría, a cambio de un riesgo si se aplica en el lugar equivocado.
Se eligió: las tres se prueban con validación cruzada y se elige la de mayor Recall. Ganó SMOTE, por una diferencia pequeña sobre el peso de clase.
¿Y si tu caso es distinto? Si tu institución no quiere generar datos sintéticos, el peso de clase da casi el mismo resultado y es más fácil de defender. Si tu desbalance es mucho más fuerte que este 39% contra 61%, la diferencia entre estrategias puede ser bastante mayor.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Sin balanceo, con peso de clase o con SMOTE?
Antes de ver el resultado, contesta esto:
Si el AUC de las tres opciones es casi idéntico, de 0.930 a 0.931, ¿en qué métrica esperas ver la diferencia?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →Cada estrategia es un Pipeline con el mismo escalado y la misma regresión logística. Solo cambia cómo se trata el desbalance, así que la diferencia se debe a eso y a nada más.
from imblearn.pipeline import Pipeline as ImbPipeline
from imblearn.over_sampling import SMOTE

metricas_cv = ["roc_auc", "recall", "precision", "f1"]

estrategias_desbalance = {
    "sin_balanceo": ImbPipeline([
        ("escalado", StandardScaler()),
        ("modelo", LogisticRegression(max_iter=1000, random_state=SEED)),
    ]),
    "class_weight_balanced": ImbPipeline([
        ("escalado", StandardScaler()),
        ("modelo", LogisticRegression(max_iter=1000, random_state=SEED, class_weight="balanced")),
    ]),
    "smote": ImbPipeline([
        ("escalado", StandardScaler()),
        ("smote", SMOTE(random_state=SEED)),
        ("modelo", LogisticRegression(max_iter=1000, random_state=SEED)),
    ]),
}

resultados_desbalance = {}
for nombre, pipe in estrategias_desbalance.items():
    scores = cross_validate(pipe, X_train, y_train, cv=cv, scoring=metricas_cv)
    resultados_desbalance[nombre] = {m: scores[f"test_{m}"].mean() for m in metricas_cv}
    print(f"{nombre:>22}: " + " | ".join(f"{m}={resultados_desbalance[nombre][m]:.3f}" for m in metricas_cv))

df_desbalance = pd.DataFrame(resultados_desbalance).T
df_desbalance sin_balanceo: roc_auc=0.930 | recall=0.791 | precision=0.893 | f1=0.839
class_weight_balanced: roc_auc=0.931 | recall=0.837 | precision=0.849 | f1=0.843
smote: roc_auc=0.931 | recall=0.843 | precision=0.842 | f1=0.843
El AUC es casi idéntico en las tres, de 0.930 a 0.931, y la diferencia está en el balance entre Recall y precisión Figura 4.
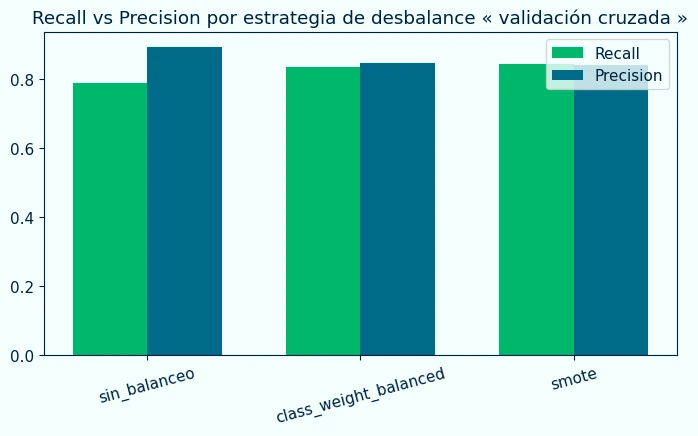
La estrategia se elige con df_desbalance["recall"].idxmax(), y el resultado es smote. El notebook guarda esa elección para construir los pipelines de las etapas siguientes.
Error común
Aplicar SMOTE antes de la validación cruzada. Si generas los ejemplos sintéticos antes de dividir en folds, algunos comparten información con ejemplos reales que caen en el fold de validación, y las métricas quedan infladas. Aquí SMOTE es un paso del ImbPipeline, va después del escalado porque trabaja con distancias, y solo se activa en el fold de entrenamiento.
Punto de adaptación: el diccionario estrategias_desbalance es donde agregas una alternativa, como otra variante de sobremuestreo: es un Pipeline más con la misma forma. El resto del código lo evalúa igual.
Checkpoint «Desbalance»
- Comparaste tres estrategias con las mismas particiones de validación cruzada
- SMOTE dio el mayor Recall, 0.843, con una precisión de 0.842
- SMOTE vive dentro del
ImbPipeline, nunca antes del split ni sobre validación o prueba
Etapa 5 de 8
Pipeline sin fuga y benchmarking
Deja documentado por qué el escalado vive dentro del Pipeline, y compara cinco modelos con exactamente las mismas reglas.
Escalar dentro de cada fold
Decisión clave
¿Escalar una sola vez sobre todo train o dentro de cada fold de validación cruzada?
Una sola vez: más simple, pero cada fold de validación termina evaluándose con un escalador que ya vio esos mismos datos.
Dentro de cada fold: el escalador se reajusta con el fold de entrenamiento y nunca ve el de validación.
Se eligió: escalar dentro de cada fold, y comparar los dos enfoques con el mismo modelo para dejar la diferencia medida en lugar de asumida.
¿Y si tu caso es distinto? Que aquí la diferencia sea cero no significa que siempre lo sea. Con imputación, selección de variables o SMOTE fuera del Pipeline, la fuga puede inflar el resultado de forma importante. Si dudas, mételo dentro.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Escalar una vez sobre todo train o dentro de cada fold de validación cruzada?
Antes de ver el resultado, contesta esto:
Si escalar fuera de la validación cruzada es fuga de datos, ¿esperas que el AUC se infle mucho con un StandardScaler? ¿De qué depende?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →from sklearn.model_selection import cross_val_score
modelo_referencia = LogisticRegression(max_iter=1000, random_state=SEED)
# Enfoque con fuga: escalar una sola vez sobre todo X_train, antes de la CV
scaler_global = StandardScaler()
X_train_escalado_global = scaler_global.fit_transform(X_train)
auc_con_fuga = cross_val_score(modelo_referencia, X_train_escalado_global, y_train,
cv=cv, scoring="roc_auc").mean()
# Enfoque correcto: el escalado vive dentro del pipeline, se reajusta en cada fold
pipeline_correcto = SkPipeline([
("escalado", StandardScaler()),
("modelo", LogisticRegression(max_iter=1000, random_state=SEED)),
])
auc_sin_fuga = cross_val_score(pipeline_correcto, X_train, y_train,
cv=cv, scoring="roc_auc").mean()
print(f"AUC con el escalador ajustado fuera de la CV « fuga leve »: {auc_con_fuga:.4f}")
print(f"AUC con el escalador dentro de cada fold « correcto »: {auc_sin_fuga:.4f}")
print(f"Diferencia: {auc_con_fuga - auc_sin_fuga:+.4f}")AUC con el escalador ajustado fuera de la CV « fuga leve »: 0.9303 AUC con el escalador dentro de cada fold « correcto »: 0.9303 Diferencia: +0.0000
La diferencia fue de 0.0000: con un StandardScaler y este dataset, la fuga es leve. El pipeline correcto se queda de todos modos, porque es el que no depende de que la fuga sea pequeña.
Benchmarking de cinco modelos
Los cinco modelos usan la estrategia de desbalance elegida y las variables del corte temprano, siempre dentro del mismo Pipeline. El criterio es AUC y Recall en validación cruzada sobre entrenamiento, nunca sobre test.
from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier
from sklearn.svm import SVC
from xgboost import XGBClassifier

def construir_pipeline(modelo, usar_smote):
    pasos = [("escalado", StandardScaler())]
    if usar_smote:
        pasos.append(("smote", SMOTE(random_state=SEED)))
    pasos.append(("modelo", modelo))
    return ImbPipeline(pasos)

usar_smote = (ESTRATEGIA_ELEGIDA == "smote")
peso_balanceado = "balanced" if ESTRATEGIA_ELEGIDA == "class_weight_balanced" else None

modelos = {
    "Logistic Regression": LogisticRegression(max_iter=1000, random_state=SEED, class_weight=peso_balanceado),
    "Random Forest":       RandomForestClassifier(random_state=SEED, class_weight=peso_balanceado),
    "Gradient Boosting":   GradientBoostingClassifier(random_state=SEED),
    "XGBoost":             XGBClassifier(random_state=SEED, eval_metric="logloss"),
    "SVM":                 SVC(probability=True, random_state=SEED, class_weight=peso_balanceado),
}

resultados_modelos = {}
for nombre, modelo in modelos.items():
    pipe = construir_pipeline(modelo, usar_smote)
    scores = cross_validate(pipe, X_train, y_train, cv=cv, scoring=["roc_auc", "recall", "f1"])
    resultados_modelos[nombre] = {
        "AUC":    scores["test_roc_auc"].mean(),
        "Recall": scores["test_recall"].mean(),
        "F1":     scores["test_f1"].mean(),
    }
    print(f"{nombre:>20}: AUC={resultados_modelos[nombre]['AUC']:.4f} | "
          f"Recall={resultados_modelos[nombre]['Recall']:.4f} | F1={resultados_modelos[nombre]['F1']:.4f}")

df_modelos = pd.DataFrame(resultados_modelos).T.sort_values("AUC", ascending=False)
df_modelos Logistic Regression: AUC=0.9306 | Recall=0.8432 | F1=0.8426
Random Forest: AUC=0.9312 | Recall=0.7970 | F1=0.8360
Gradient Boosting: AUC=0.9305 | Recall=0.8040 | F1=0.8393
XGBoost: AUC=0.9269 | Recall=0.7910 | F1=0.8283
SVM: AUC=0.9224 | Recall=0.7809 | F1=0.8173
Los resultados están en la Tabla 1.
| Modelo | AUC | Recall | F1 |
|---|---|---|---|
| Random Forest | 0.9312 | 0.7970 | 0.8360 |
| Regresión logística | 0.9306 | 0.8432 | 0.8426 |
| Gradient Boosting | 0.9305 | 0.8040 | 0.8393 |
| XGBoost | 0.9269 | 0.7910 | 0.8283 |
| SVM | 0.9224 | 0.7809 | 0.8173 |
Error común
Comparar modelos con reglas distintas. Si a un modelo le das SMOTE y a otro no, o le das variables distintas, ganas por el tratamiento de los datos y no por el algoritmo. Aquí construir_pipeline arma el mismo Pipeline para los cinco, con las mismas variables y las mismas particiones de validación cruzada.
Punto de adaptación: el diccionario modelos es donde agregas o quitas candidatos. Cualquier clasificador de scikit-learn con predict_proba entra sin tocar el resto.
Checkpoint «Pipeline»
- El escalador se ajusta dentro de cada fold: con este modelo la diferencia contra escalar fuera fue de 0.0000
- Los cinco modelos comparten variables, estrategia de balanceo y particiones de validación cruzada
- Random Forest lidera por AUC, 0.9312, y la regresión logística por Recall, 0.8432
Etapa 6 de 8
Métrica y afinación
Demuestra por qué el Accuracy no sirve para elegir, y afina el mejor modelo sin volver a filtrar información entre folds.
Por qué no elegir por Accuracy
Decisión clave
¿Con qué métrica elegir el modelo: Accuracy, Recall o AUC?
Accuracy: fácil de leer, pero premia al modelo que nunca alerta.
Recall: mide a cuántos en riesgo detectas, pero ignora cuántas falsas alarmas produces.
AUC: mide qué tan bien ordena el modelo a los estudiantes por riesgo, sin depender de un umbral.
Se eligió: AUC y Recall de validación cruzada sobre entrenamiento, con F1 como apoyo. El Accuracy no se usa para elegir; solo se reporta como contexto.
¿Y si tu caso es distinto? Si en tu institución un estudiante no detectado cuesta mucho más que una falsa alarma, Recall debe pesar más que el AUC. Si el equipo de apoyo es pequeño y no puede atender muchas alertas, la precisión pasa al frente.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Elegir el modelo por Accuracy, por Recall o por AUC?
Antes de ver el resultado, contesta esto:
Si un modelo que nunca detecta a nadie logra 0.608 de Accuracy, ¿qué te dice esa métrica sobre lo que le importa a la institución?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →La celda construye el modelo trampa explícitamente, uno que siempre predice la clase mayoritaria, y lo compara contra el mejor modelo del benchmarking.
from sklearn.dummy import DummyClassifier
from sklearn.metrics import accuracy_score, recall_score, roc_auc_score

dummy = DummyClassifier(strategy="most_frequent", random_state=SEED)
dummy.fit(X_train, y_train)
y_pred_dummy = dummy.predict(X_val)

acc_dummy    = accuracy_score(y_val, y_pred_dummy)
recall_dummy = recall_score(y_val, y_pred_dummy)

mejor_modelo_nombre = df_modelos.index[0]
print(f"Modelo trampa « siempre predice Graduate »: Accuracy={acc_dummy:.3f} | Recall={recall_dummy:.3f}")
print(f"Mejor modelo del benchmarking « {mejor_modelo_nombre} »: "
      f"AUC={df_modelos.loc[mejor_modelo_nombre, 'AUC']:.3f} | "
      f"Recall={df_modelos.loc[mejor_modelo_nombre, 'Recall']:.3f}")
print()
print("El modelo trampa gana en Accuracy y pierde por completo en Recall: no detecta ningún caso de riesgo real.")Modelo trampa « siempre predice Graduate »: Accuracy=0.608 | Recall=0.000 Mejor modelo del benchmarking « Random Forest »: AUC=0.931 | Recall=0.797 El modelo trampa gana en Accuracy y pierde por completo en Recall: no detecta ningún caso de riesgo real.
El modelo trampa gana en Accuracy y pierde por completo en Recall: acierta el 60.8% de las veces y no detecta a ningún estudiante en riesgo. Si eligieras por Accuracy, te habrías quedado con un modelo inútil que parece razonable.
Afinación del mejor modelo
El mejor modelo del benchmarking se afina con GridSearchCV, siempre dentro del mismo Pipeline. La búsqueda usa solo X_train, nunca validación ni prueba.
from sklearn.model_selection import GridSearchCV

# Un grid de hiperparámetros por tipo de modelo: la afinación es sobre
# CUALQUIERA que haya ganado el benchmarking de arriba, no un modelo fijo.
grids_por_modelo = {
    "Logistic Regression": {
        "modelo__C": [0.01, 0.1, 1, 10],
    },
    "Random Forest": {
        "modelo__n_estimators":     [200, 400],
        "modelo__max_depth":        [None, 8, 12],
        "modelo__min_samples_leaf": [1, 3, 5],
    },
    "Gradient Boosting": {
        "modelo__n_estimators":  [100, 200],
        "modelo__max_depth":     [2, 3, 4],
        "modelo__learning_rate": [0.05, 0.1],
    },
    "XGBoost": {
        "modelo__n_estimators":     [100, 200, 300],
        "modelo__max_depth":        [3, 5, 7],
        "modelo__learning_rate":    [0.05, 0.1, 0.2],
        "modelo__subsample":        [0.8, 1.0],
        "modelo__colsample_bytree": [0.8, 1.0],
    },
    "SVM": {
        "modelo__C":      [0.1, 1, 10],
        "modelo__kernel":  ["rbf", "linear"],
    },
}

pipeline_mejor = construir_pipeline(modelos[mejor_modelo_nombre], usar_smote)

grid_search = GridSearchCV(
    pipeline_mejor, grids_por_modelo[mejor_modelo_nombre],
    cv=cv, scoring="roc_auc", n_jobs=-1, verbose=1
)
grid_search.fit(X_train, y_train)

print(f"Modelo afinado: {mejor_modelo_nombre}")
print(f"Mejores parámetros: {grid_search.best_params_}")
print(f"Mejor AUC en validación cruzada: {grid_search.best_score_:.4f}")

mejor_pipeline = grid_search.best_estimator_Fitting 5 folds for each of 18 candidates, totalling 90 fits
Modelo afinado: Random Forest
Mejores parámetros: {'modelo__max_depth': None, 'modelo__min_samples_leaf': 3, 'modelo__n_estimators': 200}
Mejor AUC en validación cruzada: 0.9317
El grid del Random Forest tiene 18 candidatos, que con 5 folds son 90 ajustes. El mejor sube el AUC de validación cruzada de 0.9312 a 0.9317: una mejora de 0.0005. La afinación no cambió la historia; lo que importó fue lo que se decidió antes.
Error común
Afinar con los mismos datos con los que vas a evaluar. Si la búsqueda de hiperparámetros ve validación o prueba, el resultado final deja de ser una medición honesta. Aquí GridSearchCV solo recibe X_train y evalúa con folds internos.
Punto de adaptación: el diccionario grids_por_modelo trae un grid para cada tipo de modelo, porque la afinación se hace sobre el que gane el benchmarking, sea cual sea. Si tu modelo ganador es otro, ya tiene su grid.
Checkpoint «Métrica y afinación»
- El modelo trampa logró 0.608 de Accuracy y un Recall de 0
- El mejor modelo es Random Forest por AUC, y los tres primeros quedan a menos de 0.001 entre sí
- La afinación evaluó 18 candidatos con 90 ajustes y llegó a un AUC de 0.9317, con
max_depth=None,min_samples_leaf=3yn_estimators=200
Etapa 7 de 8
Umbral y evaluación final
Elige el punto de corte de la alerta con la validación, y mide el resultado una sola vez en el conjunto de prueba.
Umbral de alerta
Decisión clave
¿Qué umbral de probabilidad dispara la alerta?
Umbral fijo de 0.5: el valor por defecto, sin ningún significado especial para este problema.
Umbral ajustado: se calcula la curva precisión-recall en validación y se elige el punto que maximiza el F1.
Se eligió: el umbral ajustado, calculado solo sobre validación. Sale de 0.503 y se compara contra 0.5, para que el ajuste no sea un acto de fe.
¿Y si tu caso es distinto? Si tu institución tiene capacidad limitada de tutoría, elige el umbral por lo que puedes atender y no por el F1: un umbral más alto contacta a menos estudiantes, y uno más bajo contacta a más pero con menos aciertos.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Umbral fijo de 0.5 o un umbral ajustado con la curva precisión-recall?
Antes de ver el resultado, contesta esto:
El mejor umbral queda casi en 0.5. ¿Crees que ajustarlo cambió a quién se le lanza la alerta?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →from sklearn.metrics import precision_recall_curve, f1_score
y_proba_val = mejor_pipeline.predict_proba(X_val)[:, 1]
precisiones, recalls, umbrales = precision_recall_curve(y_val, y_proba_val)
f1_scores = 2 * (precisiones[:-1] * recalls[:-1]) / (precisiones[:-1] + recalls[:-1] + 1e-9)
idx_mejor_f1 = np.argmax(f1_scores)
UMBRAL_ELEGIDO = umbrales[idx_mejor_f1]
print(f"Umbral por defecto: 0.500")
print(f"Umbral elegido por F1 en validación: {UMBRAL_ELEGIDO:.3f}")
print(f"F1 en validación con umbral 0.5: {f1_score(y_val, (y_proba_val >= 0.5).astype(int)):.4f}")
print(f"F1 en validación con umbral {UMBRAL_ELEGIDO:.3f}: {f1_scores[idx_mejor_f1]:.4f}")Umbral por defecto: 0.500 Umbral elegido por F1 en validación: 0.503 F1 en validación con umbral 0.5: 0.8632 F1 en validación con umbral 0.503: 0.8652
El umbral elegido es casi el de siempre, 0.503 contra 0.5, y sube el F1 de validación de 0.8632 a 0.8652 Figura 5.
Evaluación final en test
El conjunto de prueba no se ha tocado hasta esta celda: ni en la validación cruzada, ni en la afinación, ni en la elección del umbral. Es la única vez que se usa, y se usa una sola vez.
from sklearn.metrics import classification_report, ConfusionMatrixDisplay

y_proba_test = mejor_pipeline.predict_proba(X_test)[:, 1]
y_pred_test_05      = (y_proba_test >= 0.5).astype(int)
y_pred_test_ajustado = (y_proba_test >= UMBRAL_ELEGIDO).astype(int)

print("── Umbral 0.5 ──")
print(classification_report(y_test, y_pred_test_05, target_names=["Graduate", "Dropout"]))
print(f"AUC: {roc_auc_score(y_test, y_proba_test):.4f}")
print()
print(f"── Umbral ajustado ({UMBRAL_ELEGIDO:.3f}) ──")
print(classification_report(y_test, y_pred_test_ajustado, target_names=["Graduate", "Dropout"]))── Umbral 0.5 ──
precision recall f1-score support
Graduate 0.89 0.92 0.90 332
Dropout 0.86 0.83 0.85 213
accuracy 0.88 545
macro avg 0.88 0.87 0.88 545
weighted avg 0.88 0.88 0.88 545
AUC: 0.9452
── Umbral ajustado (0.503) ──
precision recall f1-score support
Graduate 0.89 0.92 0.90 332
Dropout 0.86 0.83 0.85 213
accuracy 0.88 545
macro avg 0.88 0.87 0.88 545
weighted avg 0.88 0.88 0.88 545
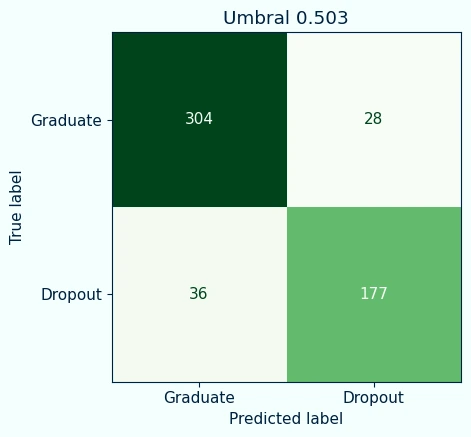
Con 0.5 y con 0.503 los dos reportes son idénticos. La Tabla 2 los resume por clase y la Figura 6 muestra la matriz de confusión con el umbral ajustado.
| Clase | Precision | Recall | F1 | Estudiantes |
|---|---|---|---|---|
| Graduate | 0.89 | 0.92 | 0.90 | 332 |
| Dropout | 0.86 | 0.83 | 0.85 | 213 |
| Exactitud global | — | — | 0.88 | 545 |
Evaluación en dos capas
Un solo número no le sirve a las dos audiencias del proyecto. Por eso el resultado se lee en dos capas: la que le importa a quien entrena el modelo y la que le importa a quien tiene que actuar sobre cada alerta.
- Capa técnica. AUC de 0.9452, Recall de 0.831 y F1 de 0.847 para la clase Dropout. El modelo ordena bien a los estudiantes por riesgo y sostiene un buen equilibrio entre detectar y acertar.
- Capa institucional. De cada 100 estudiantes que sí desertarían, el sistema alerta a 83, es decir 177 de 213. De cada 100 alertas, 86 son estudiantes que de verdad iban a desertar, es decir 177 de 205. Las 28 falsas alarmas son estudiantes que recibirían apoyo sin necesitarlo, y los 36 desertores sin detectar son el costo real del modelo.
En este conjunto de prueba, el sistema lanzaría 205 alertas sobre 545 estudiantes, el 37.6%. Ese es el número que una institución tiene que poder atender, y es la razón por la que el umbral es una decisión de capacidad y no solo de métricas.
Error común
Ajustar el umbral, o cualquier otra cosa, mirando el test. Cada vez que una decisión sale de test, deja de ser una prueba y se vuelve otro conjunto de validación. Aquí el umbral sale solo de validación, y un assert lo recalcula desde cero para comprobarlo.
Punto de adaptación: UMBRAL_ELEGIDO es la única perilla de la alerta. Cámbiala por el umbral que produzca el número de alertas que tu equipo puede atender, y vuelve a leer la matriz de confusión.
Checkpoint «Evaluación»
- El umbral se calculó solo con validación: 0.503, con F1 de 0.8652 contra 0.8632 con 0.5
- En test, AUC de 0.9452, Recall de 0.831 y F1 de 0.847 para la clase Dropout
- La matriz de confusión tiene 304, 28, 36 y 177 estudiantes, y el test se usó una sola vez
Etapa 8 de 8
Interpretabilidad con SHAP
Explica qué variables empujan cada predicción hacia la deserción o hacia la graduación. Con el corte temporal ya aplicado, son variables que existen antes de que el problema sea evidente.
El explicador depende del tipo de modelo que haya ganado el benchmarking: TreeExplainer para modelos de árboles, LinearExplainer para la regresión logística y un explicador general sobre una muestra para SVM. Para árboles se usa tree_path_dependent, que no necesita un conjunto de fondo.
!pip install -q ucimlrepo shap imbalanced-learn xgboost --upgrade

import warnings
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)

import pandas as pd
import numpy as np
import sklearn
import xgboost
import shap
import imblearn
from sklearn.model_selection import StratifiedKFold

SEED = 42
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEED)

print(f"pandas            {pd.__version__}")
print(f"numpy             {np.__version__}")
print(f"scikit-learn      {sklearn.__version__}")
print(f"xgboost           {xgboost.__version__}")
print(f"shap              {shap.__version__}")
print(f"imbalanced-learn {imblearn.__version__}")pandas 2.2.3 numpy 2.1.3 scikit-learn 1.6.1 xgboost 3.4.1 shap 0.52.0 imbalanced-learn 0.14.2
El resumen global ordena las variables por su impacto medio Figura 7. Cada punto es un estudiante de test.
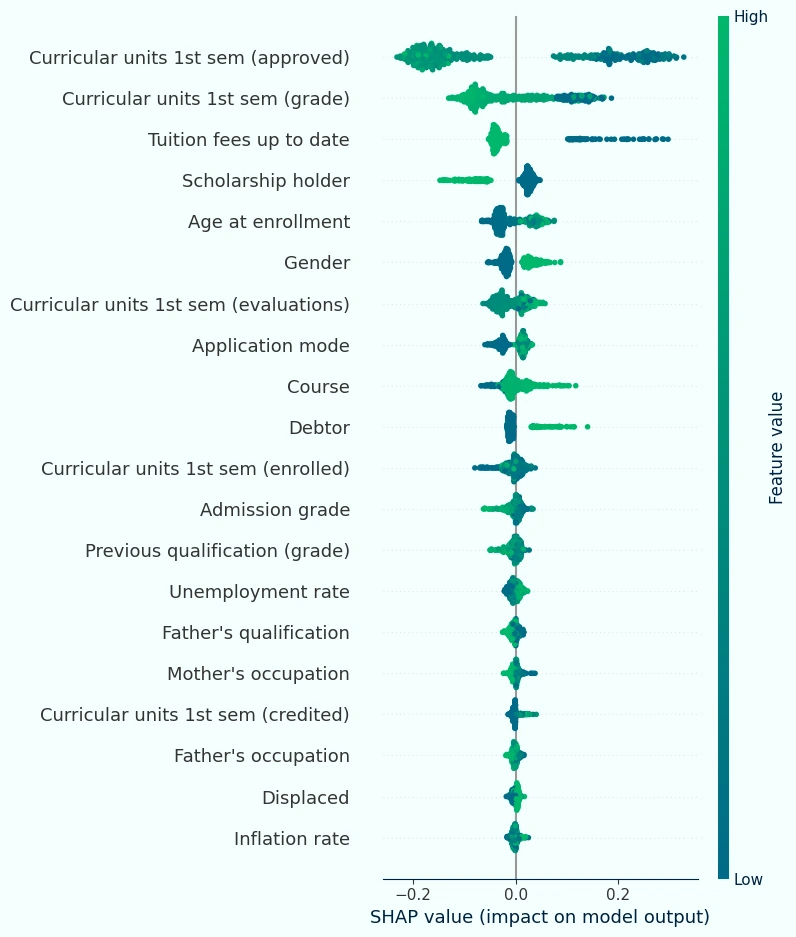
- Unidades aprobadas y calificación del 1er semestre. Son las que más pesan: quien aprueba pocas unidades en el primer semestre concentra el mayor riesgo.
- Matrícula al corriente y beca. No tener la matrícula al corriente empuja hacia la deserción, y tener beca empuja hacia la graduación. Son variables que la institución puede mover.
- Edad al inscribirse. Entrar con más edad empuja ligeramente hacia la deserción.
- Género y otras variables demográficas. Aparecen entre las diez con más peso. Conviene revisarlas con cuidado antes de usarlas en cualquier decisión sobre personas.
La explicación individual funciona igual, con una sola fila. La celda siguiente toma al estudiante de mayor riesgo entre los explicados, con una probabilidad de deserción de 1.000, y genera un gráfico de cascada con el aporte de cada variable a esa predicción.
n_shap     = X_shap.shape[0]
proba_shap = mejor_pipeline.predict_proba(X_test.iloc[:n_shap])[:, 1]
idx_ejemplo = int(np.argmax(proba_shap))

print(f"Estudiante de mayor riesgo entre los explicados con SHAP: "
      f"probabilidad de deserción = {proba_shap[idx_ejemplo]:.3f}")
# El waterfall recibe una Explanation con los nombres reales de las variables y sus
# valores originales (sin escalar), para que cada barra diga qué variable es y cuánto vale.
explicacion_individual = shap.Explanation(
    values=shap_values.values[idx_ejemplo],
    base_values=shap_values.base_values[idx_ejemplo],
    data=X_test.iloc[idx_ejemplo].values,
    feature_names=X.columns.tolist(),
)
shap.plots.waterfall(explicacion_individual)Estudiante de mayor riesgo entre los explicados con SHAP: probabilidad de deserción = 1.000
Error común
Dejar que SHAP falle o se equivoque por la forma de los valores. Con algunos modelos, como GradientBoostingClassifier, TreeExplainer devuelve un eje extra por clase aunque el problema sea binario. El código se queda solo con la clase positiva, Dropout, para tener una explicación por estudiante y por variable.
Punto de adaptación: el bloque que elige el explicador es el que tocarías si tu modelo ganador es otro. Con árboles, regresión logística o SVM ya funciona sin cambios.
Checkpoint «SHAP»
- Tienes un resumen global con nombres reales de variables y una explicación individual con la probabilidad de deserción
- Identificas que unidades aprobadas y calificación del 1er semestre, matrícula al corriente y beca son las variables de más peso
- El checklist metodológico del notebook pasa sus 6 verificaciones
Sigue: Hallazgos
Hallazgos
Hallazgos principales
- Alertar a tiempo cuesta poco AUC. Con todas las variables, incluidas las del 2do semestre, la regresión logística llegó a 0.9463; solo con admisión y 1er semestre, a 0.9303. La diferencia de 0.0159 es lo que cuesta no describir una deserción que ya ocurrió.
- El modelo que nunca alerta parece bueno. El modelo trampa logró 0.608 de Accuracy y un Recall de cero. Por eso el proyecto elige con AUC y Recall, y no con la métrica más fácil de calcular.
- Escalar fuera del Pipeline es un riesgo, aunque aquí no se note. La diferencia fue de 0.0000 con un
StandardScaler, pero el pipeline correcto no depende de esa suerte. - Los modelos casi empatan. Random Forest, regresión logística y Gradient Boosting quedaron entre 0.9305 y 0.9312 de AUC. Elegir entre ellos es más una decisión de Recall, de simplicidad y de costo de los errores que de rendimiento bruto.
- El umbral de 0.5 casi era el óptimo. El umbral ajustado fue de 0.503 y la matriz de confusión en test no cambió: 304 y 177 aciertos, 28 falsas alarmas y 36 desertores sin detectar.
- El resultado final se sostiene. En test, con una sola evaluación, el modelo llegó a un AUC de 0.9452 y detectó al 83.1% de los estudiantes que desertaron.
- Las variables que más pesan son accionables. Unidades aprobadas y calificación del 1er semestre, matrícula al corriente y beca son variables que una institución puede monitorear, y algunas puede mover.
Checklist metodológico verificado
Cada punto se verifica con código en el notebook. Si alguno falla, la celda se detiene con un error en vez de dejar pasar un resultado contaminado.
- Ninguna variable del 2do semestre llegó al conjunto de entrenamiento ni al de prueba.
- Entrenamiento, validación y prueba no comparten ninguna fila.
- El
StandardScalerdel pipeline final se ajustó solo conX_train. - El umbral se recalcula desde cero con la curva precisión-recall de validación y coincide con el de la evaluación final.
- El objetivo que predice el modelo es la columna
desercion, sin desalineación de índices. - SMOTE vive dentro del Pipeline: se aplicó solo a los folds de entrenamiento, nunca a validación ni a prueba.
Limitaciones y trabajo futuro
El proyecto demuestra el criterio correcto: evaluar sin fugas, contra un modelo trampa y con las variables que de verdad se conocen a tiempo. Sus resultados describen esta institución y esta cohorte, pero todavía no alcanzan para generalizarlos. Para llevarlo a una revista académica o a un sistema que apoye decisiones institucionales reales, estos son los cuatro frentes a fortalecer:
- Universo. Validar el mismo pipeline con datos de otra institución u otro país antes de asumir que las mismas variables pesan igual. Y sumar variables de proceso en tiempo real, como asistencia, participación en plataforma o contacto con tutores, que existen antes que cualquier calificación.
- Periodo. Es una sola cohorte. Validar con cohortes de distintos años detecta si el modelo se degrada con el tiempo, algo que un solo corte no puede mostrar. Y probar cortes intermedios, no solo «admisión más 1er semestre» contra «todo», para encontrar el punto exacto donde el Recall empieza a caer.
- Robustez. Calibrar las probabilidades con Platt Scaling o Isotonic Regression antes de usarlas para fijar niveles de riesgo, y repetir el benchmarking con bootstrap sobre el conjunto de prueba para reportar un intervalo de confianza del AUC y del Recall, no solo el punto estimado.
- Validación externa. Correr el modelo contra datos de una institución distinta a la que lo entrenó, y definir un monitoreo una vez desplegado: si el Recall en producción cae respecto al de este proyecto, es la señal de que hay que reentrenar.
Lo que realmente aprendiste
Qué te llevas: un modelo solo vale lo que gana contra la alternativa simple y lo que aporta cuando todavía se puede actuar. Sin el modelo trampa y sin el corte temporal como vara, un AUC alto parece un logro.
Qué repetirías: comparar cada decisión con su alternativa usando las mismas particiones, y verificar con código cada supuesto de no fuga antes de mirar un solo resultado.
Qué evitarías: usar variables que solo existen cuando el desenlace ya ocurrió, y elegir un modelo por el Accuracy.
Una referencia de terceros para comparar
Para ver el mismo tipo de problema abordado por otro equipo, revisa A Modular and Explainable Machine Learning Pipeline for Student Dropout Prediction in Higher Education, publicado en la revista Algorithms en 2025. Es un trabajo ajeno a este proyecto: sirve como referencia del nivel y del tipo de solución, no como evidencia de que sea trabajo propio.
¿Listo para adaptarlo a tu propio caso? La siguiente sección es justo para eso «una guía para identificar qué tocar del código antes de bajarlo y ejecutarlo tú mismo». Ir a Replica este proyecto
Parte 3 de 3
Replica este proyecto
Cómo adaptarlo a tu propio caso. Este sitio no ejecuta código «no hay sandbox ni notebook interactivo». Lo que sí puede darte es claridad total sobre qué parte del pipeline tocar cuando bajes el código y lo corras con tus propios datos, tu propio corte temporal o tu propia métrica.
Esta sección reutiliza exactamente las mismas bifurcaciones «¿Y si tu caso es distinto?» que ya viste en cada paso «aquí las juntamos para que las apliques a tu proyecto concreto».
Punto por punto: qué hacer con cada decisión clave
Si ya jugaste con el Explorador de decisiones, esto retoma cada una donde la dejaste, con la recomendación puntual para tu propio caso.
¿Predecir con todas las variables o solo con las que existen antes del 2do semestre?
Antes de entrenar, lista cada variable con el momento en que existe su valor. Si tu institución quiere alertar antes que este proyecto, tu corte es más estricto: repite la comparación con ese corte y mide cuánto AUC cuesta.
¿Sin balanceo, con peso de clase o con SMOTE?
Compara las tres con la misma validación cruzada y decide por la métrica que le importa a tu institución, no por el AUC. Si prefieres no generar datos sintéticos, el peso de clase da casi lo mismo. Y si usas SMOTE, que viva dentro del Pipeline.
¿Escalar una vez sobre todo train o dentro de cada fold de validación cruzada?
Que hoy el número no cambie no es motivo para dejarlo fuera. Con transformaciones que aprenden más de los datos, como imputación, selección de variables o SMOTE, la diferencia sí puede ser grande. Deja todo lo que se ajusta dentro del Pipeline.
¿Elegir el modelo por Accuracy, por Recall o por AUC?
Elige la métrica antes de ver resultados y escríbela junto al costo de cada error: qué cuesta no alertar a un estudiante en riesgo y qué cuesta contactar a uno que no lo estaba. Si los primeros modelos empatan en AUC, decide por Recall o por simplicidad.
¿Umbral fijo de 0.5 o un umbral ajustado con la curva precisión-recall?
Ajústalo siempre con validación, nunca con test, y compáralo contra 0.5. Si tu institución tiene capacidad limitada de tutoría, el umbral es la perilla que decide a cuántos estudiantes contactas: define primero cuántos puedes atender.
Qué puedes cambiar sin romper nada
- El dataset «cualquier tabla con un desenlace binario y variables por semestre funciona con el mismo código: cambia
df_crudoy la columna objetivo». - La semilla y los folds «
SEEDycvviven en la celda de configuración; moverlos no afecta la arquitectura del pipeline». - La estrategia de desbalance «
estrategias_desbalancees un diccionario de Pipelines: agregar una alternativa es agregar una entrada». - Los modelos candidatos y sus grids «
modelosygrids_por_modelodefinen quién compite y cómo se afina; cualquier clasificador conpredict_probaentra». - El umbral de alerta «
UMBRAL_ELEGIDOes la única perilla de la alerta; cámbialo por el que produzca el número de alertas que tu equipo puede atender».
Qué es más difícil de tocar «y por qué»
- Cambiar el corte temporal «no es solo editar una lista de columnas: implica saber en qué momento se registra cada variable en tu institución y repetir la comparación de la Etapa 3, porque todo lo posterior depende de ese corte».
- Agregar variables de proceso en tiempo real «asistencia o actividad en plataforma llegan como series por estudiante, no como una fila, así que cambian la forma de los datos y del corte».
- Alertar en varios momentos del semestre «un sistema que alerte en cada corte necesita un modelo o un umbral por corte y un monitoreo por cohorte, no un solo pipeline».
- Decidir qué variables demográficas conservar «género o nacionalidad pueden aparecer entre las de más peso; usarlas o no es una decisión de la institución, no técnica, y cambia qué modelo puedes defender».
Guía de auto-diagnóstico «antes de bajar el código»
Responde esto para ti mismo primero. No es un cuestionario para entregar «es para que sepas, antes de tocar una línea, en qué parte vas a pasar más tiempo».
1. ¿Sabes en qué momento se registra cada variable de tus datos?
Investiga: lista cada variable con la fecha en que su valor existe en tu sistema, y marca las que se registran después del punto en que quieres alertar.
Señal de que vas bien: puedes justificar en una frase, para cada variable, por qué existe antes de la alerta «si no puedes, probablemente describe el desenlace en vez de anticiparlo».
2. ¿Qué cuesta más en tu institución: no alertar a un estudiante en riesgo o contactar a uno que no lo estaba?
Investiga: pregunta al equipo de tutoría cuántas alertas puede atender por semana y qué pasa con el estudiante que nadie contactó.
Señal de que vas bien: puedes traducir esa capacidad a un umbral y elegir la métrica principal antes de ver un solo resultado.
3. ¿Tus datos tienen desenlace para todos los estudiantes, y qué proporción deserta?
Investiga: cuenta las clases y revisa si hay estudiantes que todavía no tienen desenlace, como los Enrolled de este dataset. Esos no se pueden usar para aprender.
Señal de que vas bien: después del split estratificado, la proporción de la clase minoritaria es casi la misma en entrenamiento, validación y prueba.
Variantes ya pensadas, por si buscas un punto de partida
- Variante 1: comparar varios cortes temporales. Repite la Etapa 3 con más de un corte, por ejemplo solo admisión, admisión más 1er semestre y todas las variables, y grafica AUC y Recall contra el corte. Es un buen eje de contribución original si estás pensando en una tesis.
- Variante 2: calibrar las probabilidades. Agrega Platt Scaling o Isotonic Regression antes de elegir el umbral, para que una probabilidad de 0.7 signifique de verdad un riesgo cercano al 70% y puedas fijar niveles de atención.
- Variante 3: validar con otra institución. Corre el mismo pipeline, sin reajustar nada, con los datos de otra institución. Si el Recall se mantiene, tienes evidencia de que el modelo generaliza; si cae, sabes qué variables no viajan.
Adáptalo con IA
Lo anterior es la vía manual: tú decides qué tocar y lo escribes. Esta es la vía asistida: un prompt ya armado con el contexto del proyecto, las mismas restricciones que evitaron los errores comunes de cada etapa, y los mismos checkpoints como criterios para verificar lo que el modelo te entregue.
CONTEXTO
Voy a adaptar un pipeline de Machine Learning para predecir la deserción estudiantil como sistema de alerta temprana, con estas etapas en este orden: (1) carga de datos y definición del problema como clasificación binaria, deserción contra graduación, (2) split estratificado 70, 15 y 15, (3) corte temporal que deja solo las variables que existen antes del punto en que se emite la alerta, (4) Pipeline con escalado, balanceo de clases y modelo dentro de cada fold de validación cruzada, (5) benchmarking de cinco modelos y afinación con GridSearchCV, (6) umbral de alerta elegido con la curva precisión-recall de validación y (7) evaluación final en test, una sola vez, con explicación SHAP. Voy a correrlo con los datos de mi institución, con mi propio corte temporal y, si aplica, con otro modelo o métrica. No cambies el orden de las etapas.

RESTRICCIONES (no las rompas al generar o modificar código)
1. Una variable entra al modelo solo si su valor existe antes de la fecha en que se emite la alerta. Antes de entrenar, lista cada variable con el momento en que se registra y descarta las posteriores al corte.
2. El escalado, el balanceo de clases, la imputación y cualquier transformación que aprenda de los datos viven dentro de un Pipeline y se ajustan solo con el fold de entrenamiento.
3. El split es estratificado por la clase de deserción, y validación y test conservan la proporción del entrenamiento.
4. El modelo se elige con Recall, F1 y AUC de validación cruzada sobre entrenamiento, nunca con Accuracy, y siempre se compara contra un modelo que predice la clase mayoritaria.
5. El umbral de alerta se elige con la curva precisión-recall de validación, nunca con test, y se compara contra 0.5.
6. El conjunto de test se usa una sola vez, al final, después de fijar variables, modelo, hiperparámetros y umbral.

CRITERIOS DE ACEPTACIÓN (verifica esto antes de dar el resultado por bueno)
1. Hay un assert que comprueba que ninguna variable posterior al corte llegó a entrenamiento ni a test.
2. Hay un assert que comprueba que entrenamiento, validación y test no comparten índices.
3. Hay un assert que comprueba que la media del escalador del pipeline final es la de X_train.
4. Hay un assert que recalcula el umbral desde cero solo con validación y coincide con el usado en la evaluación final.
5. Hay un assert que comprueba que el balanceo de clases vive dentro del Pipeline y no se aplicó a validación ni a test.
6. El reporte incluye Recall, Precision y F1 de la clase de deserción, el AUC y la matriz de confusión, junto con la comparación contra el modelo trampa.
7. Hay una explicación SHAP global y una individual, con los nombres reales de las variables.

Pídeme confirmar cada criterio de aceptación uno por uno antes de continuar a la siguiente etapa.
Si ya conoces la metodología SDD «Constitution y Verify», estas mismas restricciones y criterios son tu Constitution y tu paso de Verify: úsalos ahí en vez del prompt simple de arriba.
Siguiente paso real: abre el notebook y córrelo tal cual antes de cambiar nada. Ver el resultado base, con sus tablas y su checklist verificado, es lo que te va a dejar claro, con evidencia propia, exactamente dónde necesitas intervenir.
¿Necesitas más ayuda?
¿Tu tesis requiere análisis de datos o modelos de ML? Trabajemos juntos.
Quiero información