Predicción de ventas, detección de anomalías y segmentación de clientes
Sigue leyendo si tienes un historial de ventas y tres preguntas distintas que responderle « cuánto se va a vender, qué día algo no encaja, qué tipos de cliente hay » y no te basta con copiar código: quieres entender por qué cada pregunta se mide distinto, para poder desarrollar tu propio proyecto.

Parte 1 de 3
Contexto del proyecto
Al terminar, sabrás hacer esto
No son conceptos abstractos. Son decisiones que podrás tomar y justificar en una tesis, en una entrevista o en un proyecto real.
- Tres tareas, un mismo historial: construyes pronóstico, detección de anomalías y segmentación sobre un solo dataset transaccional, y aprendes a medir cada una con la pregunta que de verdad responde.
- Backtest sin fugas: diseñas un backtest de origen móvil en el que ningún modelo ve un solo mes posterior al que tendría que pronosticar, y verificas con código que ningún rezago se calculó con el futuro.
- Modelos globales para series cortas: decides cuándo compartir información entre productos ayuda más de lo que arriesga, y lo pruebas con bootstrap en vez de asumirlo.
- Métricas que pesan lo que pesa el negocio: eliges entre MAPE, WAPE y MASE sabiendo qué error comete cada una y a quién beneficia.
- Detección robusta de anomalías: construyes un detector que distingue un evento real, como una pandemia, de un error, y que encuentra tanto picos como rachas de silencio.
- Segmentación validada con el futuro: calificas clientes con RFM y comprueban qué tan bien anticipan la recompra real, no solo qué tan separados quedan los grupos.
- Criterio para adaptarlo: identificas en qué punto del pipeline tocar el código si cambian tu catálogo, tus sucursales o tu horizonte de decisión.
Modos de uso
- Tesis: comparación rigurosa de referencias simples contra Machine Learning en tres tareas de negocio, con el mismo protocolo de evaluación para las tres.
- Trabajo: pipeline replicable con cualquier catálogo transaccional de retail.
- Portafolio: demuestra que sabes evaluar pronóstico, detección de anomalías y segmentación cada uno contra su propia vara, no solo entrenarlos.
Prerrequisitos
- Python intermedio: funciones, listas/diccionarios, y haber usado pandas o numpy alguna vez. No necesitas ser experto.
- Nociones de estadística básica: mediana, desviación estándar y qué es un cuantil. Se usa constantemente en las tres tareas.
- Cero experiencia previa en detección de anomalías o segmentación RFM. Eso es justo lo que cubre la siguiente sección.
Brief del proyecto
Eres analista de datos en un retailer con cuatro sucursales. El gerente comercial te pide tres cosas: saber cuánto va a vender cada producto el próximo mes, identificar qué días algo no encaja en las ventas antes de que llegue al reporte financiero, y entender qué tipos de cliente tiene el negocio.
Las tres preguntas parecen del mismo tamaño, pero no se responden igual. Un pronóstico se mide contra el pronóstico ingenuo. Un detector de anomalías se mide contra anomalías conocidas. Una segmentación se mide contra lo que los clientes hacen después. Medir las tres con la misma vara sería un error tan grave como no medirlas.
Qué está en juego: un pronóstico que sobreestima genera sobrestock; uno que subestima genera roturas de inventario. Una detección de anomalías con demasiados falsos positivos hace que el equipo deje de confiar en el sistema y apague las alertas. Y una segmentación que no anticipa nada dirige campañas de reactivación al segmento equivocado.
Este es un proyecto demostrativo, no un consejo de inventario o de retención de clientes: hay demasiadas variables de negocio en juego para tomarlo como tal.
Los datos reales del negocio son confidenciales, así que la primera decisión del proyecto « antes de tocar un modelo » es cómo desarrollarlo y publicarlo sin comprometer información sensible. La siguiente sección explica esa decisión y lo que se ve en el diagrama de la Figura 1.
Diagrama de la solución
Un solo historial de ventas, limpio una sola vez, responde tres preguntas de negocio distintas, cada una con su propia manera de comprobarse (Figura 1).
Datos y fricción real
Antes de tocar el pipeline, esto es lo que realmente te vas a encontrar en los datos de este proyecto « no una advertencia genérica sobre "datos sucios", sino la fricción concreta que después justifica decisiones puntuales más adelante ».
- Los datos reales son confidenciales, y aun así el proyecto es reproducible. Los datos de este notebook son sintéticos, generados con una semilla fija para conservar la distribución, el volumen y el realismo del original: estacionalidad semanal y anual, la caída por la pandemia, la apertura tardía de una sucursal, la concentración de ventas en pocos productos y la mezcla de clientes frecuentes y ocasionales. Ningún nombre, código ni identificador corresponde a un cliente, producto o documento real.
- La limpieza es una decisión, no un paso automático. Duplicados exactos, documentos anulados, códigos que no son producto « descuentos, servicios de terceros » y devoluciones se tratan distinto: los primeros se eliminan, las devoluciones se separan porque no son demanda pero sí restan del valor que aportó cada cliente.
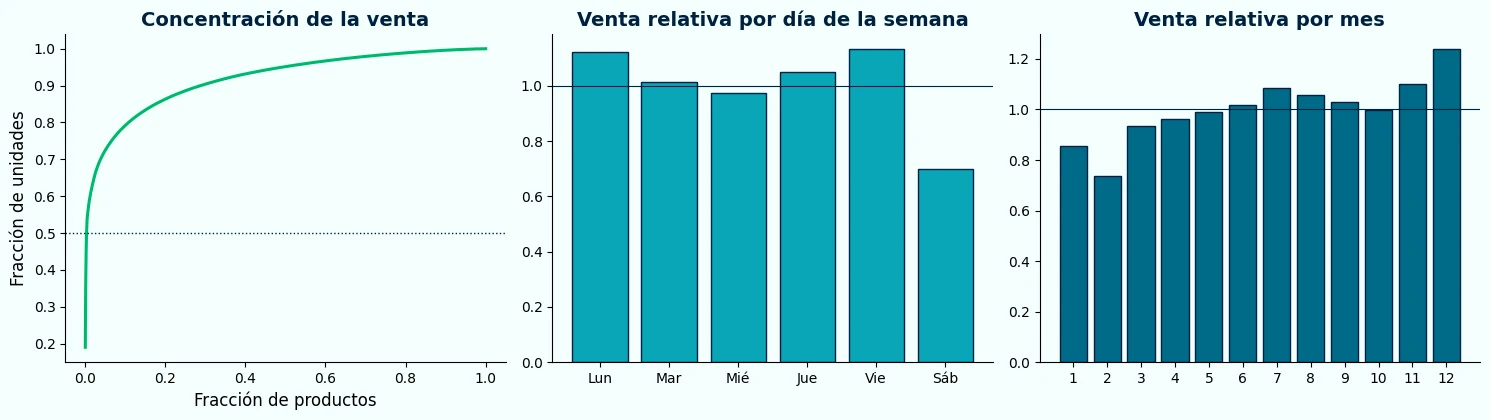
- La venta está muy concentrada. Un puñado de productos explica la mayor parte de las unidades vendidas, así que el pronóstico se enfoca en los 20 productos de mayor volumen en vez de intentar pronosticar los 3,000 códigos del catálogo con el mismo esfuerzo.
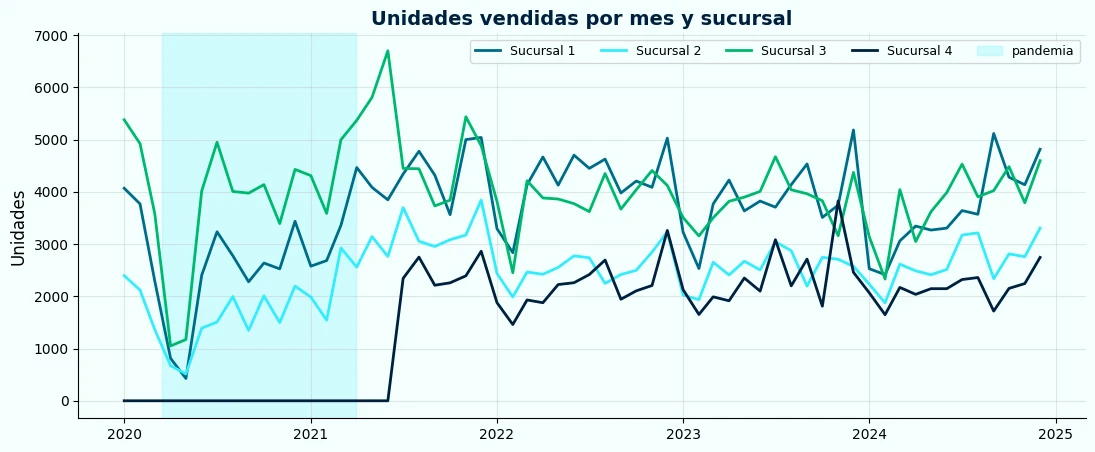
- Hay dos cosas que parecen anómalas y no lo son. El pico de diciembre y la caída por la pandemia son patrones reales, no errores. Por eso la evaluación de anomalías se reporta también solo con el periodo posterior a la pandemia, que es el escenario real de monitoreo.
- Una ventaja que solo existe porque los datos son sintéticos. Se conocen las anomalías que se inyectaron y el tipo real de cada cliente. Esas etiquetas se guardan aparte y ningún modelo las ve, solo se usan al final para evaluar « algo imposible de tener con datos reales ».
Fundamentos teóricos de la solución
Estas tres ideas son la base conceptual de todo lo que sigue. Si ya conoces alguna, puedes saltarla.
No hay código aquí a propósito. La idea es que entiendas qué resuelve cada pieza antes de ver cómo se implementa.
En resumen:
- Backtest de origen móvil responde "¿este pronóstico habría funcionado con la información que existía ese día?".
- Estadística robusta responde "¿qué tan raro es este valor, sin dejar que los propios valores raros distorsionen la respuesta?".
- RFM responde "¿qué tan valioso y qué tan activo es este cliente, con solo tres números?".
Con estas tres ideas ya tienes el mapa mental completo: lo que sigue es ver cómo se traduce en código.
¿Qué es un backtest de origen móvil?
La idea central, en una frase: el modelo solo puede usar la información que habría existido el día que tenía que decidir. Un split que mezcla los meses, o un escalador ajustado con datos de prueba, le dan al modelo información del futuro que en la vida real nunca habría tenido.
Un backtest de origen móvil repite esa disciplina varias veces: en cada fecha de decisión T, el modelo se entrena solo con datos anteriores a T, pronostica el periodo siguiente, y el origen avanza. Al final tienes muchas mediciones fuera de muestra, no una sola, lo que permite además usar bootstrap para saber si una diferencia entre dos modelos es real o cabe en el ruido.
En este proyecto, con solo 24 meses de backtest, esa pregunta « ¿la ventaja es real? » importa tanto como cuál modelo ganó en la tabla.
¿Qué es un z robusto y por qué no basta la desviación estándar?
Un z-score normal mide cuántas desviaciones estándar se aleja un valor de la media. El problema: si ya hay valores anómalos en los datos, esos mismos valores inflan la desviación estándar, y un pico real puede terminar pareciendo «normal» a los ojos de la fórmula.
La versión robusta reemplaza la media por la mediana y la desviación estándar por la desviación absoluta mediana « MAD »: ambas se dejan arrastrar mucho menos por los propios outliers. En este proyecto, «lo esperado» para un día es la mediana de los mismos días de la semana en las 4 semanas anteriores, y la dispersión se mide con el MAD de los 60 días previos.
Eso resuelve la mitad del problema: los picos de venta alta. La otra mitad, las rachas de días sin venta, necesita su propio detector, porque un z-score sobre valores en cero no distingue una racha de tres días de una de quince.
¿Qué es RFM y qué problema resuelve?
RFM describe a cada cliente con tres números: Recencia « días desde su última compra », Frecuencia « cuántas veces ha comprado » y Monto « cuánto ha gastado en total ». Es una forma simple de resumir todo el historial transaccional de un cliente sin perder lo que más le importa a marketing.
A partir de ahí hay dos caminos. Calificar a cada cliente del 1 al 5 en cada dimensión con reglas fijas « quintiles », una práctica clásica que no aprende nada de los datos. O dejar que un algoritmo de clustering, como K-means o una mezcla gaussiana, encuentre los grupos por similitud.
La pregunta que de verdad importa no es cuál método separa mejor los grupos, sino cuál anticipa mejor lo que los clientes van a hacer después. Ese es el estándar contra el que se mide cada método en este proyecto.
Explorador de decisiones
Antes de leer cómo se construyó el pipeline, prueba tú mismo dos de sus decisiones. Es una muestra rápida — las 5 decisiones del proyecto se exploran igual, justo donde aparecen en el desarrollo.
Parte 2 de 3
Desarrollo del proyecto
¿Qué construyes?
Un pipeline de tres módulos independientes que comparten un mismo historial de transacciones limpio una sola vez: pronóstico mensual de ventas, detección diaria de anomalías y segmentación de clientes con RFM. Cada módulo tiene su propia forma de evaluarse, su propia decisión clave y su propio Explorador « ya lo probaste arriba con dos de las cinco ».
Decisión clave del proyecto completo: nunca comparar un método contra sí mismo. El pronóstico se compara contra tres referencias que no aprenden nada, la detección de anomalías contra las cinco alternativas más usadas en la práctica, y la segmentación contra reglas de negocio simples que tampoco aprenden. Si un método sofisticado no le gana a la alternativa simple, su complejidad no se justifica.
Insight que atraviesa el proyecto: en las tres tareas, la referencia que no aprende nada es más difícil de vencer de lo que parece, y en al menos un módulo « la segmentación » terminó ganando.
Etapa 1 de 6
Datos y reproducibilidad
Fija todo el experimento en una sola celda, y carga o genera el historial de transacciones sintéticas: 5 años, 4 sucursales, con la caída de la pandemia y la apertura tardía de una sucursal ya incluidas en el generador.
El proyecto corre en Jupyter local o en Google Colab, sin GPU. Con el entorno estándar de Colab corre completo en 10 a 15 minutos.
Configuración del experimento
SEED = 42

FECHA_INICIO    = "2020-01-01"
FECHA_FIN       = "2024-12-31"
INICIO_BACKTEST = "2023-01-01"    # primer mes pronosticado
LAGS            = [1, 2, 3, 6, 12]
N_BOOTSTRAP     = 2000

UMBRAL_Z             = 4.0        # z robusto a partir del cual se levanta alerta
ALPHA_RACHA          = 0.001      # probabilidad bajo la cual una racha sin venta es alerta
INICIO_POSPANDEMIA   = "2021-04-01"

FIN_AJUSTE_SEGMENTOS = "2024-01-01"   # RFM con datos hasta 2023; 2024 solo para validar
Limpieza del historial
Cada regla se aplica por una razón de negocio, no por costumbre: duplicados exactos porque son la misma línea exportada dos veces, documentos anulados porque esa venta no ocurrió, descuentos y servicios de terceros porque no son unidades de un producto, y devoluciones separadas porque no son demanda pero sí restan del valor de cada cliente.
Nota sobre el dataset sintético
Los datos reales del proyecto son información confidencial del negocio y no se pueden compartir. El dataset sintético conserva la distribución, el volumen y el realismo del original. Se agrega esta nota tanto en el artículo como en el notebook.
Etapa 2 de 6
Análisis exploratorio
Cuatro preguntas, cada una condiciona una decisión posterior:
- ¿Cómo evoluciona la venta? Si hay estacionalidad y eventos como la pandemia, el pronóstico necesita variables de calendario y el detector de anomalías tiene que distinguir un evento de un error.
- ¿Qué tan concentrada está la venta? Si pocos productos explican casi todo, tiene sentido pronosticarlos uno por uno y no intentar el catálogo completo con el mismo esfuerzo.
- ¿Qué pasa con cada día de la semana y cada mes? Es la estructura que cualquier modelo debería reproducir « sábados más flojos, diciembre más fuerte ».
- ¿A qué nivel pronosticar? Lo resuelve la primera Decisión clave de la siguiente etapa.
Etapa 3 de 6
Lo que cambió en el camino
La primera versión de este proyecto llegó a resultados que se veían bien, pero varios no resistían una revisión. Se documentan porque son los errores más comunes en proyectos de este tipo, y el checklist metodológico del final los verifica con código.
Errores comunes « primera ronda »
- Meses barajados. El pronóstico dividía los datos con
train_test_split, que por defecto mezcla las filas: el modelo se entrenaba con meses posteriores a los que después "pronosticaba". - La fecha como variable one-hot. Cada mes de prueba era una columna que el modelo nunca había visto: no aportaba nada y sí agregaba ruido.
- Preprocesamiento con el test. El escalador se ajustaba con entrenamiento y prueba juntos.
- Rezagos rellenados con cero. Los primeros meses sin historia se llenaban con ceros, como si en esos meses no se hubiera vendido nada.
- Un baseline que ve el futuro. La referencia de comparación era el promedio del propio periodo de prueba.
- Un modelo que nunca se entrenó. La red de la comparación estaba vacía, y su resultado era una copia de otro modelo.
- Anomalías sin verdad contra la cual medir. Los detectores se calificaban con un índice fijado de antemano, sin saber cuáles días eran realmente anómalos.
- Un valor de venta sin relación con el producto. El generador asignaba el monto al azar, vaciando de sentido la parte monetaria del RFM.
Y lo que cambió después de la primera corrida ya sin fugas
- Ningún detector encontraba un quiebre de stock. La venta diaria es irregular y un día sin venta es normal; lo anómalo es una racha, y ningún método evaluaba rachas hasta que se agregó ese detector.
- Los pedidos atípicos eran demasiado evidentes. Todos los métodos los detectaban. Se agregaron pedidos moderados, de 2.5 a 4 veces lo normal, que sí separan a un buen detector de uno malo.
- Isolation Forest competía con desventaja. Recibía niveles de venta y no desviaciones de lo esperado. Ahora recibe las dos cosas.
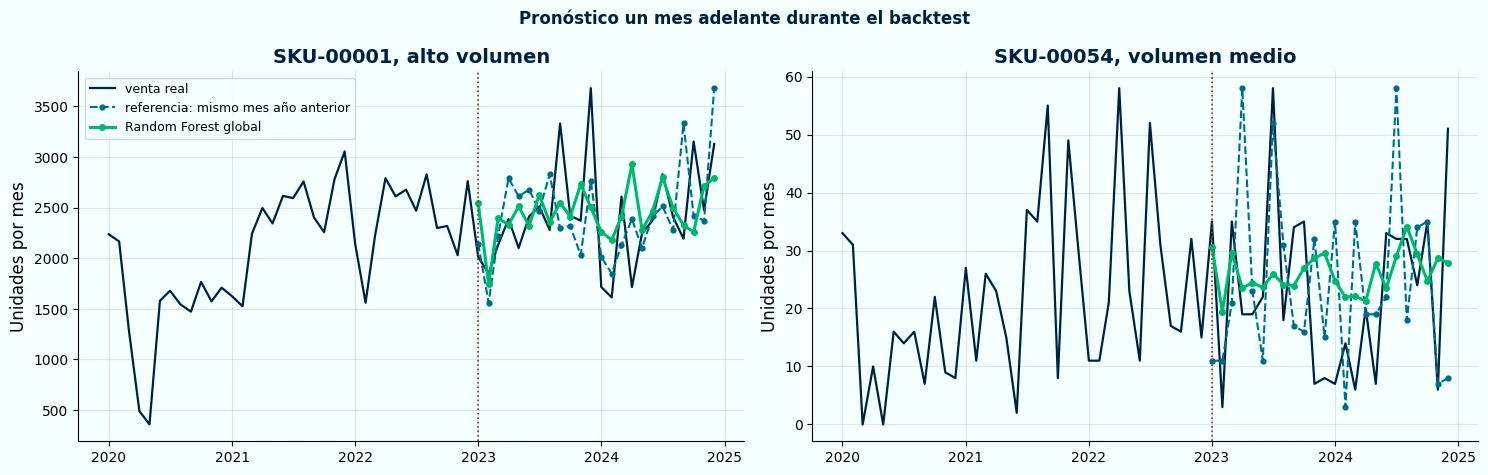
- Las métricas coincidían porque todos los productos vendían mucho. El problema del MAPE aparece en volumen medio, así que ahora esos productos entran al backtest.
- Las reglas RFM desempataban al azar. Con muchos clientes de una sola compra, el ranking asignaba quintiles distintos a clientes idénticos. Ahora la frecuencia usa cortes fijos.
Todo lo que sigue corrige estos trece puntos.
Etapa 4 de 6
Pronóstico de ventas
Rezagos de 1, 2, 3, 6 y 12 meses y promedios móviles de 3 y 12, todos calculados solo con meses anteriores al que se pronostica. Mes del año en forma cíclica « seno y coseno, para que diciembre y enero queden cerca », días hábiles del mes y un indicador de pandemia. Los meses sin historia suficiente se descartan, no se rellenan con cero.
Decisión clave
¿Pronosticar por día o por mes?
El pronóstico diario da más detalle, pero para la mayoría de los productos un día típico es cero o casi cero, y un modelo que aprende a decir «cero» parece preciso sin servir para nada. Este proyecto pronostica por mes.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Pronosticar por día o por mes?
Antes de ver el resultado, contesta esto:
Si en el nivel diario 84% de los días no hay venta de un producto de volumen medio, ¿qué aprendería un modelo entrenado con esa serie?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →Decisión clave
¿Un modelo por producto o un modelo global para todos?
Con 5 años de historia, cada producto tiene unos 48 meses utilizables, y al inicio del backtest solo 24. Un modelo global aprende de los 20 productos a la vez, escalando cada uno por su propio volumen promedio calculado solo con entrenamiento. Es la estrategia que dominó competencias de pronóstico con muchas series cortas, como la M5.
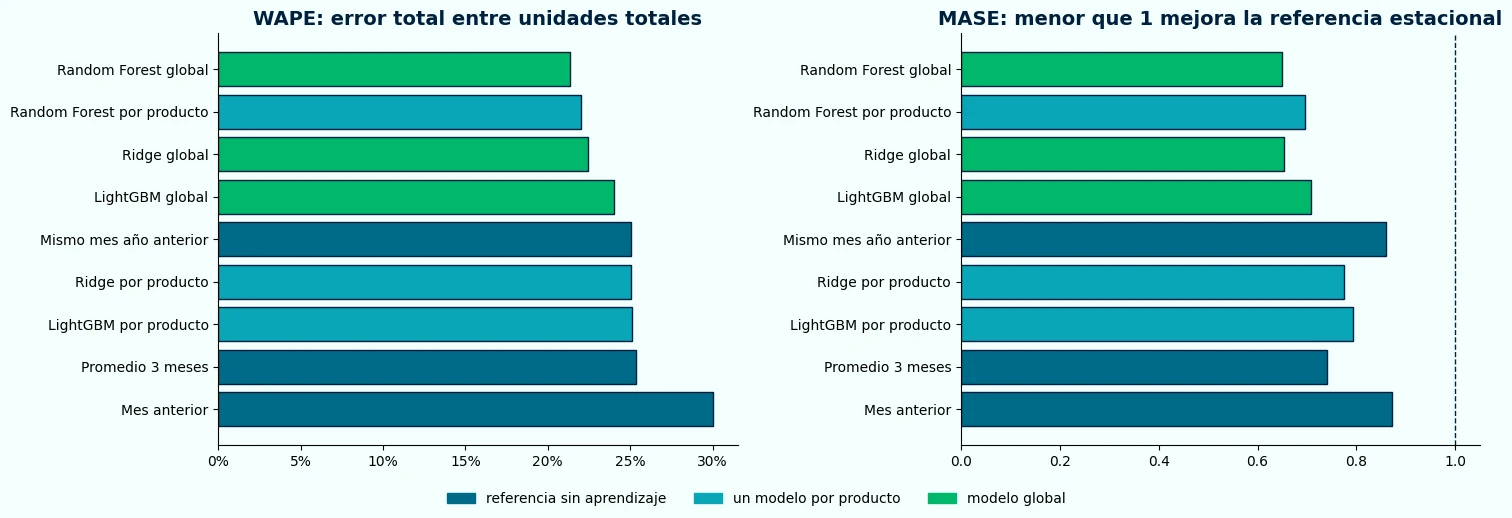
Modelos comparados: las tres referencias sin aprendizaje « mes anterior, mismo mes año anterior, promedio 3 meses », Ridge, Random Forest y LightGBM, cada uno en su versión por producto y global.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Un modelo por producto o un modelo global para todos?
Antes de ver el resultado, contesta esto:
Con 24 a 48 observaciones por producto, ¿un modelo que solo ve un producto a la vez tiene datos suficientes para aprender un patrón confiable?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →def nuevo_modelo(nombre):
"""Instancia un modelo nuevo por nombre; el resto del pipeline
solo espera un .fit / .predict, sin importar cuál sea."""
if nombre == "Ridge":
return make_pipeline(StandardScaler(), Ridge(random_state=SEED))
if nombre == "Random Forest":
return RandomForestRegressor(n_estimators=300, random_state=SEED)
if nombre == "LightGBM":
return LGBMRegressor(random_state=SEED, verbosity=-1)
raise ValueError(nombre)
# Escalado del modelo global: el volumen promedio se calcula SOLO
# con el entrenamiento de cada producto, nunca con el backtest.
escala = df_train.groupby("producto")["cantidad"].mean()
y_train_escalado = df_train["cantidad"] / df_train["producto"].map(escala)
# ... entrenar sobre y_train_escalado, y multiplicar la predicción
# de vuelta por escala[producto] antes de medir el error real.Decisión clave
¿Con qué métrica elegir el modelo: MAPE, WAPE o MASE?
El MAPE pesa un mes chico igual que uno grande: un error de pocas unidades en un producto de bajo volumen se vuelve un porcentaje enorme. WAPE pesa cada producto según lo que vende, como lo pesa el inventario. MASE divide el error contra el de la referencia estacional: menor a 1 confirma una mejora real.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Con qué métrica elegir el modelo: MAPE, WAPE o MASE?
Antes de ver el resultado, contesta esto:
Si un producto vende 5 unidades un mes y el modelo predice 7, el MAPE de ese mes es 40%. ¿Qué le hace ese número al promedio si el resto del catálogo vende cientos de unidades?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →Checkpoint
Antes de seguir a la evaluación, confirma: (1) todo el entrenamiento de cada mes pronosticado es anterior a ese mes; (2) el escalado del modelo global se calculó solo con entrenamiento; (3) los rezagos recalculados desde la serie original coinciden con los del panel de features. El checklist metodológico del notebook corre estas tres verificaciones con assert.
Etapa 5 de 6
Detección de anomalías
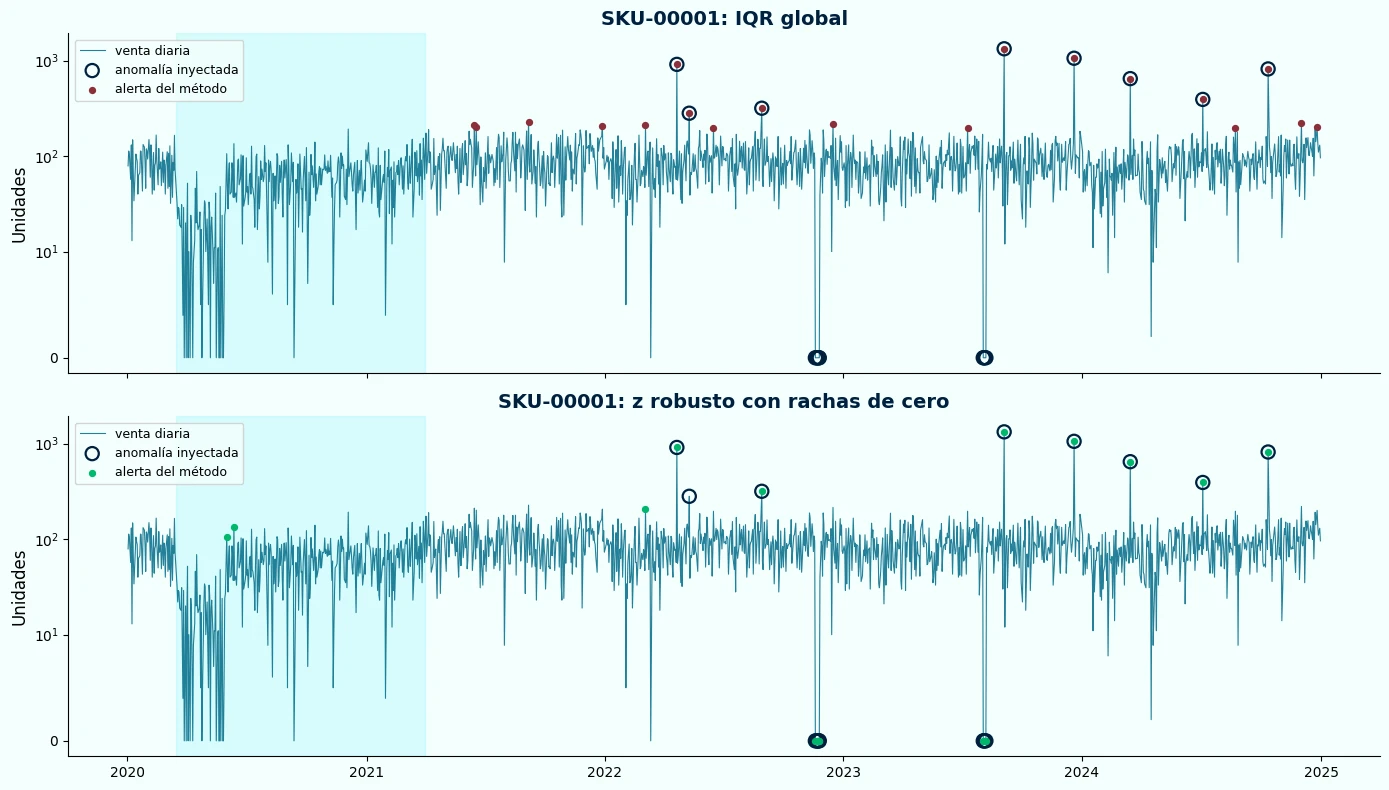
La pregunta de negocio es: ¿qué días la venta de un producto no encaja con lo esperado? El dataset sintético contiene casos conocidos de cuatro tipos: pedido atípico evidente « 6 a 12 veces lo normal », pedido atípico moderado « 2.5 a 4 veces, el caso difícil », error de captura « una cantidad cien veces más grande » y quiebre de stock « 4 a 7 días seguidos sin vender ».
Decisión clave
¿Qué método de detección de anomalías usar?
IQR global y DBSCAN comparan cada día contra la distribución de toda la serie: simples, pero no saben qué es normal para cada momento. Isolation Forest aísla los días fáciles de separar, con un presupuesto de revisión del 1%. El z robusto sobre el residuo compara cada día contra la mediana de los mismos días de la semana en las 4 semanas anteriores. Las rachas de cero miden qué tan improbable es una racha de días sin venta.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Qué método de detección de anomalías usar?
Antes de ver el resultado, contesta esto:
Un quiebre de stock no se ve en ningún día aislado, solo en una racha de varios días seguidos sin venta. ¿Qué tipo de método puede encontrar eso: uno que mira un día a la vez, o uno que mira rachas?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →Error común
Evaluar un detector de monitoreo diario sobre todo el periodo, incluida la pandemia. La pandemia fue un cambio de régimen, no una anomalía: un detector que la marca como anómala no está fallando, está juzgado en el escenario equivocado. Por eso la evaluación se reporta dos veces, con el periodo completo y solo con la operación posterior a la pandemia.
Checkpoint
Antes de confiar en las alertas: (1) el z robusto y el disparo de la alerta de racha de un día dan el mismo resultado si se recalculan con la serie cortada en ese día; (2) ningún detector recibe las etiquetas de anomalía, solo la serie de ventas. Ambos puntos corren como assert en el checklist metodológico.
Etapa 6 de 6
Segmentación de clientes
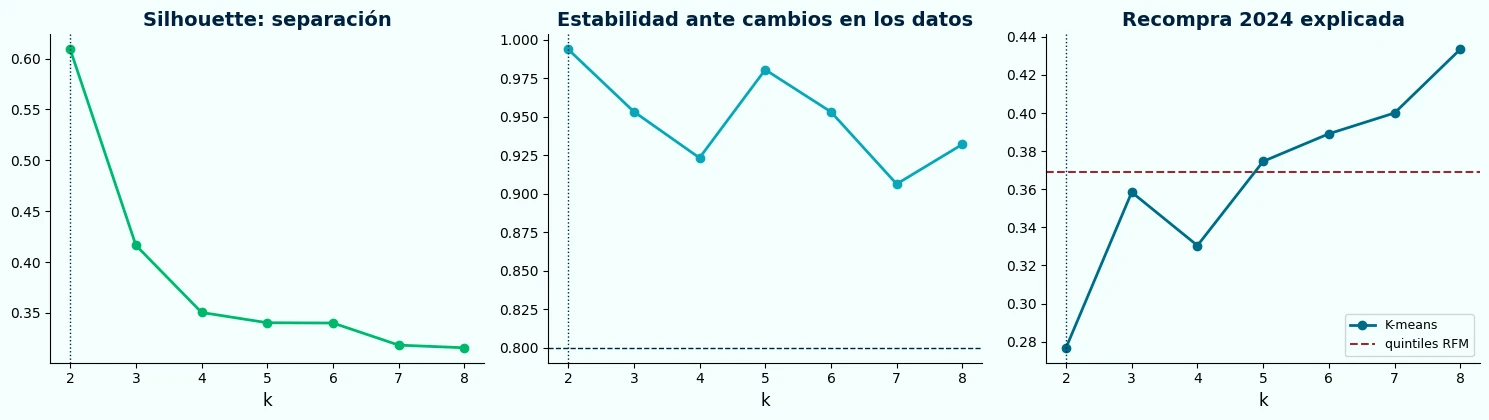
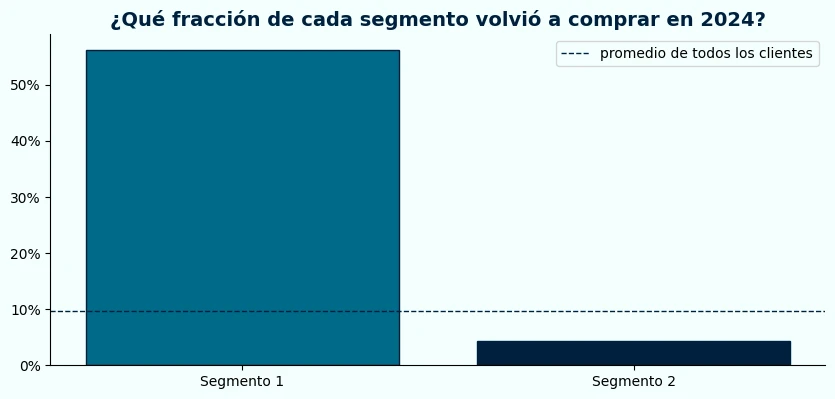
¿Qué tipos de cliente tiene el negocio y a quién conviene cuidar? Recencia, Frecuencia y Monto se calculan con datos hasta el 31 de diciembre de 2023. Todo 2024 queda fuera del cálculo y se usa después para responder la pregunta que de verdad importa: ¿los segmentos anticipan quién vuelve a comprar y cuánto gasta?
Decisión clave
¿K-means, mezcla gaussiana o reglas RFM por quintiles?
K-means agrupa clientes cercanos entre sí. La mezcla gaussiana « GMM » permite grupos de distinta forma y tamaño, a cambio de más parámetros. Las reglas por quintiles califican a cada cliente del 1 al 5 en cada dimensión con cortes fijos: no aprenden nada, y justo por eso son la vara con la que se mide a los otros dos.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿K-means, mezcla gaussiana o reglas RFM por quintiles?
Antes de ver el resultado, contesta esto:
Si un método de clustering se parece más al tipo real de cliente pero explica menos la recompra futura, ¿cuál de los dos resultados debería pesar más para una campaña de retención?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →Checkpoint
Antes de dar la segmentación por buena: (1) el RFM y su escalado se calcularon solo con datos hasta la fecha de corte, nunca con 2024; (2) clientes con la misma frecuencia reciben la misma calificación de quintil, sin desempate al azar.
Hallazgos
Los números concretos de esta corrida los redacta el notebook en su celda de resumen automático, para que la conclusión nunca se escriba antes de ver el resultado. Lo que el diseño del experimento deja claro, sin importar qué método gane en una corrida futura:
- Un pronóstico solo vale lo que mejora a la mejor alternativa simple, y la mejora hay que demostrarla. Ganarle en una tabla no basta: con 24 meses, el bootstrap dice si la ventaja es real o cabe en el ruido « aquí, Random Forest global le ganó a la referencia con 98% de confianza, pero no le ganó de forma demostrada al modelo por producto ».
- Con muchas series cortas, compartir información entre productos es una decisión de diseño que se prueba, no una receta. El modelo global ganó en la tabla, la ventaja sobre el modelo por producto no llegó al 95% que exige el bootstrap.
- La métrica tiene que pesar lo que pesa el negocio. En alto volumen, MAPE, WAPE y MASE no coinciden en el ganador; en volumen medio, sí. Que coincidan o no fue un resultado, no un supuesto.
- Cada tipo de anomalía necesita su propia prueba. Un pico se ve en un solo día; un quiebre de stock no se ve en ningún día aislado, solo en una racha. Cuatro de cinco métodos nunca encontraron un quiebre de stock.
- Un detector se evalúa en el escenario donde va a operar. Separar la pandemia del resto evitó juzgar al detector por un cambio de régimen que no le tocaba vigilar.
- Una segmentación se valida con lo que los clientes hacen después, no solo con qué tan separados quedan los grupos. Las reglas RFM, el método que no aprende nada, explicaron más recompra real que K-means o GMM, aunque su parecido con el tipo real de cliente fue el más bajo de los tres.
Lo que realmente aprendí
El resultado más incómodo de este proyecto no fue técnico: fue que el método que no aprende nada, RFM por quintiles, le ganó a dos algoritmos de Machine Learning en la métrica que de verdad importaba. Es tentador no reportarlo o esconderlo entre las métricas internas del clustering, donde K-means sí se ve mejor. No hacerlo « medir contra el futuro real, aunque el resultado incomode » es la misma disciplina que el resto del proyecto le exige al pronóstico y a las anomalías.
Un trabajo reciente y público con un enfoque similar, evaluación honesta de pronóstico contra referencias simples con series cortas: Makridakis, S., Spiliotis, E. & Assimakopoulos, V. (2022). M5 accuracy competition: Results, findings, and conclusions. International Journal of Forecasting.
Parte 3 de 3
Replica este proyecto
Cómo adaptarlo a tu propio caso. Este sitio no ejecuta código « no hay sandbox ni notebook interactivo ». Lo que sí puede darte es claridad total sobre qué parte del pipeline tocar cuando bajes el código y lo corras con tu propio catálogo, tus propias sucursales o tu propio horizonte de decisión.
Esta sección reutiliza exactamente las mismas bifurcaciones « "¿y si tu caso es distinto?" » que ya viste en cada etapa « aquí las juntamos para que las apliques a tu proyecto concreto ».
Punto por punto: qué hacer con cada decisión clave
Si ya jugaste con el Explorador de decisiones, esto retoma cada una donde la dejaste « con la recomendación puntual para tu propio caso ».
¿Pronosticar por día o por mes?
Si tu catálogo vende varias veces por día por producto, el pronóstico diario puede tener sentido. Antes de intentarlo, mide qué fracción de periodos quedan en cero con tu propio historial: por arriba de 50%, el mensual sigue siendo la apuesta más segura.
Volver a explorarla ↻¿Un modelo por producto o un modelo global para todos?
nuevo_modelo() y el escalado por volumen promedio, calculado solo con entrenamiento, son las únicas piezas que tocas si cambias de estrategia. Con menos de 20 series o series muy distintas entre sí en escala, repite el bootstrap antes de asumir que el modelo global sigue ganando en tu caso.
Volver a explorarla ↻¿Con qué métrica elegir el modelo: MAPE, WAPE o MASE?
Si tu inventario se valora por unidades y no por número de productos, WAPE sigue siendo la vara correcta. Si en cambio cada producto tiene un margen muy distinto, considera ponderar el error por margen en vez de por unidades vendidas.
Volver a explorarla ↻¿Qué método de detección de anomalías usar?
UMBRAL_Z y ALPHA_RACHA son los dos parámetros que ajustas primero. Si tu negocio no tiene quiebres de stock relevantes que detectar, el z robusto solo puede bastar y te ahorras la complejidad de vigilar rachas.
Volver a explorarla ↻¿K-means, mezcla gaussiana o reglas RFM por quintiles?
Antes de asumir que necesitas un modelo de clustering, corre las reglas por quintiles como referencia. Si tu negocio tiene una lógica de negocio clara para calificar clientes, esa regla simple puede ganarle a K-means o a GMM también en tu caso.
Volver a explorarla ↻Qué puedes cambiar sin romper nada
- El catálogo de productos, las sucursales o el rango de fechas: el pipeline no asume ningún nombre ni cantidad fija, solo columnas de fecha, sucursal, cliente, producto, cantidad y valor.
- El número de productos a pronosticar «
N_PRODUCTOS» y el rango de volumen medio a incluir en el backtest. - Los umbrales de detección de anomalías,
UMBRAL_ZyALPHA_RACHA, según qué tan sensible quieras que sea cada alerta. - El número de clusters de la segmentación, o directamente los cortes de los quintiles si tu negocio ya tiene su propia definición de "cliente VIP".
Qué es más difícil de tocar « y por qué »
- El diseño del backtest de origen móvil. Cambiar cómo se parte el tiempo es el punto con más riesgo de reintroducir una fuga; cualquier cambio aquí debe volver a pasar el checklist metodológico completo.
- La ventana de "lo esperado" del z robusto. 4 semanas y un MAD de 60 días fueron calibrados para la estacionalidad de este negocio. Con un ciclo de ventas muy distinto « por ejemplo, semanal en vez de mensual », esas ventanas necesitan recalibrarse, no solo copiarse.
- La fecha de corte de la segmentación. Tiene que dejar suficiente periodo posterior para medir recompra real; con menos de 6 a 12 meses de validación, la comparación entre métodos deja de ser confiable.
Guía de auto-diagnóstico « antes de bajar el código »
- ¿Tu historial tiene menos de 2 años? El modelo global y los rezagos de 12 meses van a tener poco con qué trabajar; considera reducir
LAGSy apoyarte más en las referencias sin aprendizaje. - ¿Tu negocio no tiene quiebres de stock relevantes? El z robusto solo puede bastarte, sin la complejidad de las rachas de cero.
- ¿Ya tienes una definición de negocio para "cliente VIP"? Empieza por las reglas por quintiles antes de entrenar cualquier modelo de clustering: en este proyecto, la regla simple ganó.
Variantes ya pensadas, por si buscas un punto de partida
- Pronóstico por categoría de producto en vez de por SKU individual, para catálogos con miles de referencias y rotación baja por producto.
- Métodos específicos para demanda intermitente, como Croston o TSB, para el catálogo de cola larga que este proyecto agrupa en "el resto".
- Un detector de anomalías multivariado que combine cantidad y valor de venta en la misma alerta, en vez de vigilarlos por separado.
- Segmentación con variables adicionales al RFM clásico, como categoría de producto preferida o canal de compra.
Adáptalo con IA
Lo anterior es la vía manual: tú decides qué tocar y lo escribes. Esta es la vía asistida — un prompt ya armado con el contexto del proyecto, las mismas restricciones que evitaron los errores comunes de cada etapa, y los mismos checkpoints como criterios para verificar lo que el modelo te entregue.
CONTEXTO
Voy a adaptar un pipeline que responde tres preguntas sobre un mismo historial de ventas transaccional: (1) pronóstico mensual de ventas por producto, comparado contra tres referencias sin aprendizaje (mes anterior, mismo mes del año anterior, promedio 3 meses) y evaluado con backtest de origen móvil, WAPE y MASE; (2) detección diaria de anomalías por producto con un detector robusto sobre el residuo esperado más un detector de rachas de días sin venta; (3) segmentación de clientes con RFM, validada contra la recompra real de un periodo posterior. Voy a correrlo con mi propio catálogo de productos, mis propias sucursales o canales, y si aplica, mi propio horizonte de pronóstico o mi propio periodo de validación de segmentos. No cambies el orden de las tres preguntas ni mezcles sus evaluaciones.

RESTRICCIONES (no las rompas al generar o modificar código)
1. Nunca dividas series de tiempo con un split que mezcle filas (nada de train_test_split aleatorio ni shuffle=True): el periodo de prueba siempre es posterior al de entrenamiento.
2. Los rezagos y promedios móviles se calculan solo con periodos anteriores al que se pronostica o evalúa. Los periodos sin historia suficiente para calcularlos se descartan, nunca se rellenan con cero.
3. Cualquier detector de monitoreo (residuo robusto, rachas) debe depender solo del pasado: recalcularlo con la serie cortada en una fecha T tiene que dar el mismo resultado que calcularlo sobre la serie completa hasta T.
4. El RFM y cualquier escalado de segmentación se ajustan solo con datos anteriores a la fecha de corte. El periodo que usas para validar (la recompra futura) nunca entra al cálculo de RFM ni al escalado.
5. Compara siempre contra la alternativa que no aprende nada: las referencias sin ML para el pronóstico, y una regla de negocio simple (por ejemplo RFM por quintiles) para la segmentación.

CRITERIOS DE ACEPTACIÓN (verifica esto antes de dar el resultado por bueno)
1. Hay un assert que comprueba que ningún rezago o feature del pronóstico usa información del periodo que se está pronosticando.
2. Los indicadores y detectores recalculados con la serie recortada en una fecha T dan el mismo valor en T que calculados sobre la serie completa.
3. El RFM y su escalado se ajustaron solo con filas anteriores a la fecha de corte de segmentación, verificado explícitamente.
4. El reporte del pronóstico incluye WAPE y MASE, no solo MAPE, con la mejor referencia sin aprendizaje como vara de comparación y la probabilidad de que la mejora sea real, no ruido.
5. El reporte de anomalías separa cualquier periodo de régimen excepcional (una pandemia, un cambio de sistema) del resto, y reporta precisión y recall por tipo de anomalía, no un solo score agregado.
6. La segmentación se valida contra comportamiento real de un periodo posterior, no solo contra métricas internas del clustering.

Pídeme confirmar cada criterio de aceptación uno por uno antes de continuar a la siguiente etapa.
Si ya conoces la metodología SDD (Constitution/Verify), estas mismas restricciones y criterios son tu Constitution y tu paso de Verify — úsalos ahí en vez del prompt simple de arriba.
¿Necesitas más ayuda?
¿Tu tesis requiere análisis de datos o modelos de ML? Trabajemos juntos.
Quiero información