/ Proyectos / Salud / Clasificación de leucemia
Clasificación de leucemia linfoblástica aguda: CNN con data augmentation por GAN
Clasificación de imágenes de frotis sanguíneo en 4 subtipos de LLA, entrenando una GAN por clase para compensar el desbalance del dataset antes de clasificar con una CNN.
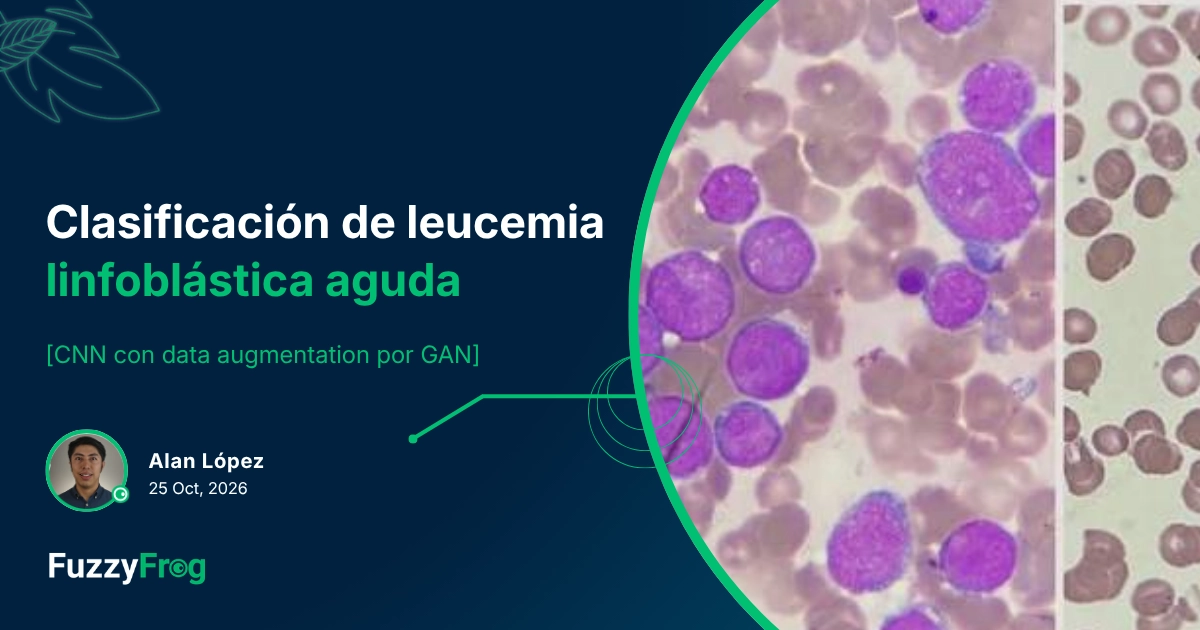
Nota importante: este proyecto es una herramienta educativa y de investigación sobre clasificación de imágenes médicas. No es un dispositivo de diagnóstico clínico y ninguna predicción de este pipeline debe usarse para decisiones médicas reales.
El objetivo era clasificar imágenes de frotis de sangre periférica en 4 clases: hematógonos benignos y tres subtipos de linfoblastos malignos (Pre-B temprana, Pre-B, Pro-B). El problema real: el dataset público disponible está desbalanceado desde el origen, con casi el doble de imágenes en la clase mayoritaria que en la minoritaria, y las células benignas pueden confundirse visualmente con linfoblastos malignos incluso para un observador entrenado.
Se diseñó un pipeline en dos etapas: una GAN entrenada por clase para generar imágenes sintéticas adicionales, compensando el desbalance con variabilidad morfológica real en vez de solo transformaciones geométricas, y una CNN vanilla para la clasificación final. El hallazgo más importante no fue de arquitectura, fue de datos: la decisión de invertir en generar datos sintéticos por clase, en vez de solo reponderar la función de pérdida, es lo que hace este pipeline replicable a otros problemas médicos con datasets pequeños y desbalanceados.
Mapa del casoContenido
- Diagrama de la solución. Los bloques del pipeline, de la imagen de entrada a la clase predicha
- Construcción de la solución. Cómo el desbalance real del dataset dirigió cada decisión
- Condiciones del proyecto. Restricciones reales y opciones descartadas antes de construir
- Pasos. Qué se dejó al agente y qué criterio se aplicó en cada uno
- Proceso de iteración. El error real que se encontró y corrigió en la arquitectura de la GAN
- Descargables. Notebook, diagrama y repositorio del proyecto
- Lecciones importantes. La lección concreta que deja este caso
Estructura de alto nivelDiagrama de la solución
Pasa el cursor sobre cada bloque para ver que hace ese paso.
La GAN se entrena por clase, no una sola GAN condicionada a las 4 clases, porque el objetivo era controlar de forma independiente cuánta variabilidad sintética se agrega a cada clase según su déficit real de ejemplos.
De la teoría a la prácticaConstrucción de la solución
Condiciones del proyecto
| Restricción | Dato |
|---|---|
| Fuente del dataset | Público (Kaggle, Aria et al. 2021), 3,256 imágenes de 89 pacientes |
| Distribución de clases | 504 Benign, 985 Early, 963 Pre, 804 Pro — desbalance real, no de muestreo |
| Similitud visual entre clases | Hematógonos benignos y linfoblastos malignos tempranos son difíciles de distinguir incluso para un observador entrenado |
| Uso previsto del modelo | Educativo y de investigación, no diagnóstico clínico |
| Opción | Por qué se descartó |
|---|---|
| Solo reponderar la función de pérdida por clase | Corrige el sesgo del entrenamiento, pero no añade variabilidad morfológica real a la clase minoritaria |
| Data augmentation solo con transformaciones geométricas (rotación, flip, zoom) | Genera variantes de la misma imagen, no ejemplos con variabilidad celular nueva |
| GAN entrenada por clase para generar ejemplos sintéticos adicionales | Aprende y sintetiza variabilidad morfológica plausible específica de cada clase |
Pasos
Preprocesamiento de las imágenes
Agente: propuso normalizar directamente a [0, 1] como es más común.
Criterio aplicado: normalizar a [-1, 1], porque la capa de salida del generador de la GAN usa activación `tanh`, cuyo rango de salida es [-1, 1] — las imágenes reales y las generadas deben compartir la misma escala.
Diseño del generador de la GAN
Agente: propuso una arquitectura de generador estándar sin verificar que la dimensión de salida coincidiera con la del discriminador.
Criterio aplicado: calcular explícitamente cuántas capas `Conv2DTranspose` con stride 2 se necesitan para llegar de 7×7 a 224×224 (5 capas: 7→14→28→56→112→224), y verificarlo ejecutando el modelo antes de asumir que la arquitectura estaba completa.
Separación de datos de entrenamiento y prueba
Agente: propuso mezclar imágenes reales y sintéticas antes de hacer el split train/test.
Criterio aplicado: asegurar que las imágenes sintéticas generadas a partir de una imagen real no terminen simultáneamente en train y test, para no inflar artificialmente el accuracy por fuga de datos.
Elección de la arquitectura de clasificación
Agente: propuso partir directamente de una arquitectura preentrenada (transfer learning) sin justificar la elección.
Criterio aplicado: empezar con una CNN vanilla simple como baseline explícito, dejando el transfer learning como extensión documentada, no como punto de partida — así la mejora de cualquier arquitectura más compleja se mide contra algo concreto.
Proceso de iteración
Ajuste documentado, no forzado
El generador de la GAN, tal como estaba diseñado originalmente con 4 capas `Conv2DTranspose`, producía imágenes de 112×112 píxeles, pero el discriminador esperaba 224×224. El error solo apareció al ejecutar el pipeline completo: ValueError: Input... incompatible with the layer: expected shape=(None, 224, 224, 3), found shape=(None, 112, 112, 3). La causa fue simple una vez identificada, faltaba una quinta capa de upsampling, pero el error no era evidente solo leyendo el código, solo se detectó al correrlo. La lección: verificar las formas de salida de cada bloque de una GAN antes de conectar generador y discriminador ahorra tiempo de depuración más adelante.
CierreLecciones importantes
El generador de una GAN necesita que su forma de salida se verifique explícitamente contra la entrada del discriminador, ese tipo de error no aparece leyendo el código, solo al ejecutarlo. El desbalance de clases en un dataset médico pequeño se resuelve mejor generando variabilidad morfológica nueva por clase que solo reponderando la pérdida o rotando las mismas imágenes. Y ningún número de accuracy tiene valor sin verificar primero que no hay fuga de datos entre entrenamiento y prueba, sobre todo cuando las imágenes sintéticas derivan de un conjunto reducido de imágenes reales.
Si quieres ver un enfoque publicado con una idea similar, clasificación de leucemia sobre este mismo dataset con arquitecturas más complejas, este paper de los propios creadores del dataset es una buena referencia del nivel de la contribución: Ghaderzadeh et al. (2022), A fast and efficient CNN model for B-ALL diagnosis and its subtypes classification using peripheral blood smear images.
Termina ya tu proyecto
¿Tienes un proyecto similar y no sabes por dónde empezar? Yo te ayudo a diseñarlo.
El 92% de los profesionales de datos desbloquea sus proyectos al ver ejemplos completos resueltos.
Sin registro. Acceso inmediato